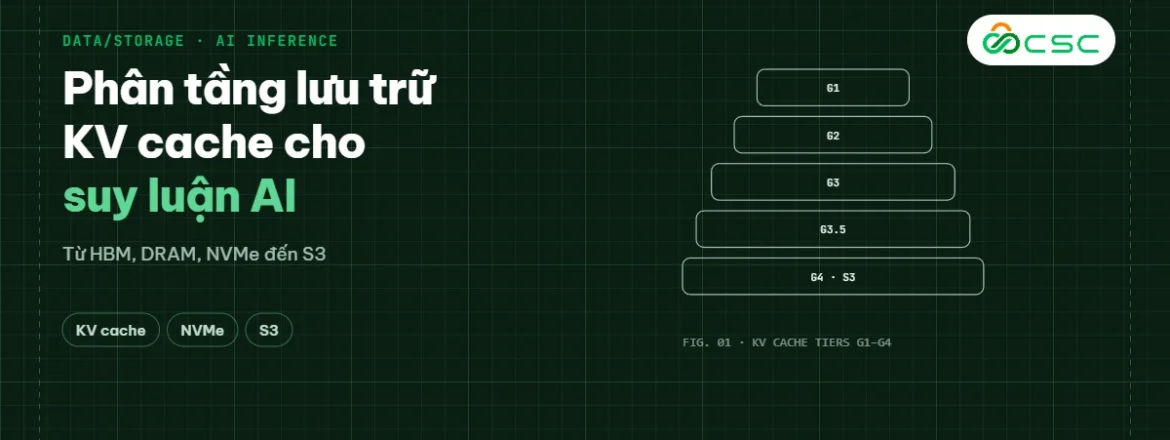
Phân tầng lưu trữ KV cache cho suy luận AI: từ HBM đến S3
Lưu trữ KV cache cho suy luận AI: các tầng G1–G4 từ GPU, RAM, NVMe tới storage dùng chung, cách tính dung lượng và chọn tầng theo khối lượng công việc.
Read More


Lưu trữ KV cache cho suy luận AI: các tầng G1–G4 từ GPU, RAM, NVMe tới storage dùng chung, cách tính dung lượng và chọn tầng theo khối lượng công việc.
Read More
Hướng dẫn chọn máy chủ GPU Supermicro cho hạ tầng inference GenAI: tính VRAM, KV cache, so sánh GPU, cấu hình PCIe 4–8 GPU và HGX. Hỗ trợ sizing từ CSC.
Read More
Tuần qua chứng kiến những bước tiến vượt bậc trong lĩnh vực lưu trữ dữ liệu, điện toán đám mây và trí tuệ nhân tạo. Các tập đoàn công nghệ hàng đầu thế giới đã liên tục ra mắt các giải pháp tích hợp AI, tăng cường bảo mật và mở rộng hạ tầng lượng […]
Read More

Value-Added-Distributor