Cloudian HyperStore với NVIDIA GPUDirect: 15 câu hỏi thường gặp
NVIDIA GPUDirect • Lưu trữ đối tượng cho AI
Cloudian HyperStore kết hợp NVIDIA GPUDirect giúp dữ liệu từ object storage đi tới GPU theo đường trực tiếp hơn, giảm vai trò trung gian của CPU, giảm độ trễ và tăng thông lượng cho workload AI.
Tổng quan công nghệ NVIDIA GPUDirect
1. NVIDIA GPUDirect là gì?
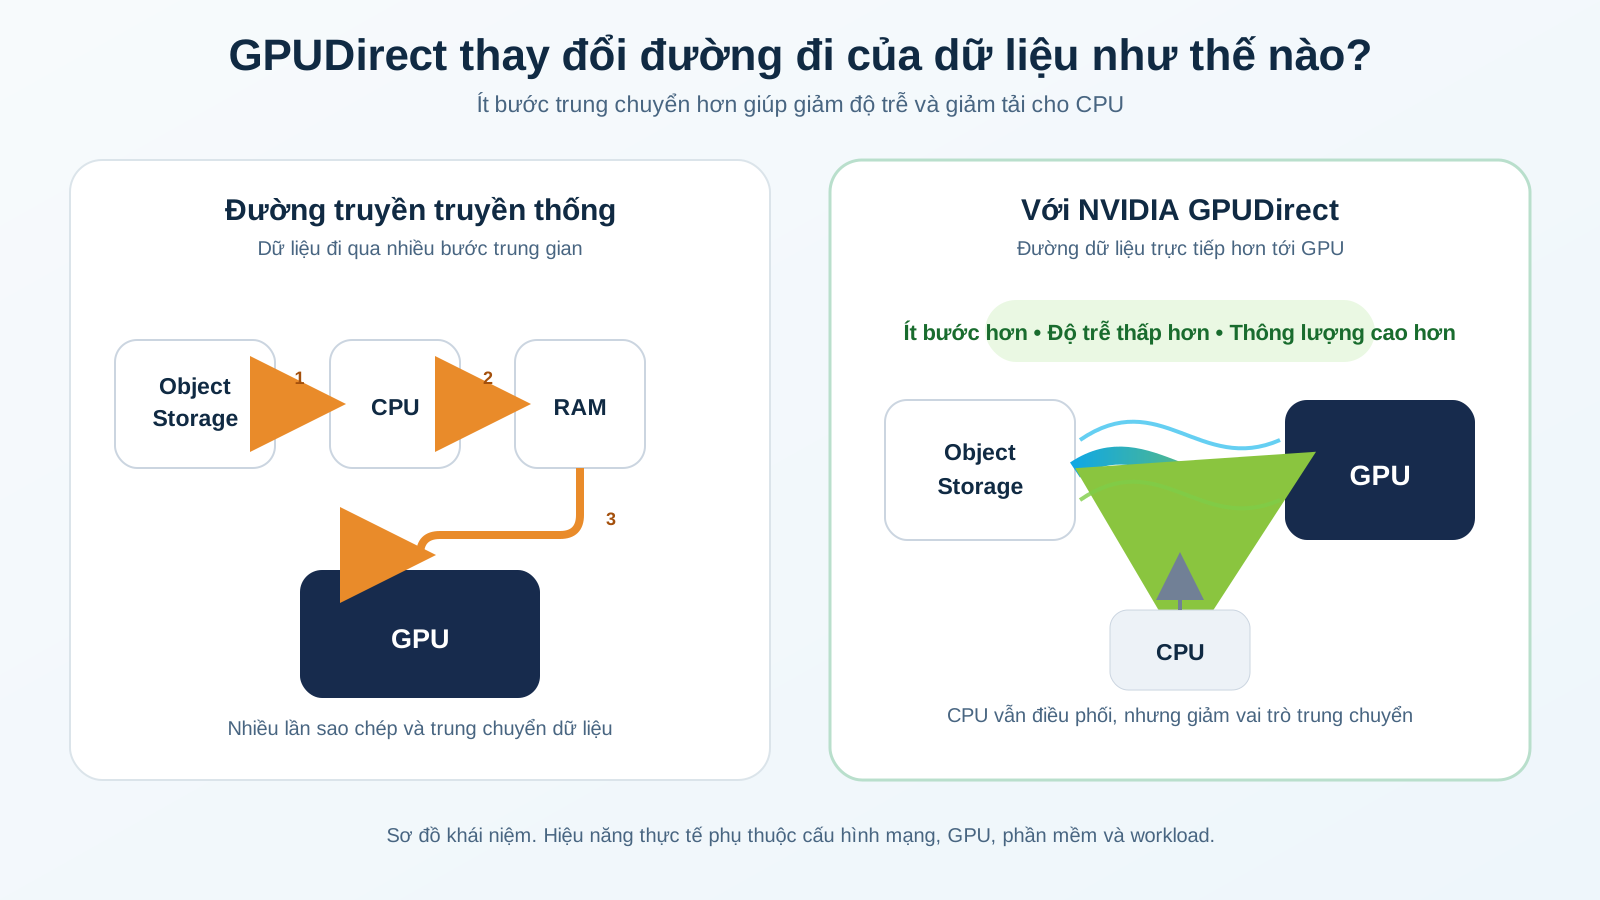
NVIDIA GPUDirect là công nghệ phần mềm giúp GPU trao đổi dữ liệu với mạng và lưu trữ theo đường truyền trực tiếp hơn, giảm việc dữ liệu phải đi vòng qua CPU.
Theo cách truyền thống, CPU và bộ nhớ chính thường đóng vai trò trung chuyển dữ liệu trước khi dữ liệu tới GPU. GPUDirect giảm bớt các bước này, từ đó có thể giảm độ trễ và tăng tốc xử lý cho các tác vụ đọc lượng dữ liệu lớn như huấn luyện AI, deep learning hoặc phân tích video.
Phù hợp với: tất cả nhóm độc giả.
2. Cloudian HyperStore với NVIDIA GPUDirect for Object Storage là gì?
Đây là giải pháp cho phép nhiều node Cloudian HyperStore gửi dữ liệu từ object storage trực tiếp hơn tới GPU, đồng thời vẫn sử dụng các lệnh theo chuẩn S3.
Theo tài liệu Cloudian dùng làm nguồn cho bài FAQ, Cloudian đã phối hợp với NVIDIA để xây dựng thư viện hỗ trợ GPUDirect cho object storage. Giải pháp tận dụng khả năng xử lý song song của nhiều node và giảm phần overhead trên đường dữ liệu qua CPU/HTTP.
Nói đơn giản: doanh nghiệp có thể dùng kho dữ liệu đối tượng dung lượng lớn làm nguồn dữ liệu hiệu năng cao hơn cho GPU, thay vì luôn phải bổ sung một tầng file storage riêng chỉ để cấp dữ liệu cho AI.
Phù hợp với: lãnh đạo, IT, kiến trúc sư giải pháp, đội AI, sales/presales.
3. Giải pháp này khác gì so với cách dùng file storage hiệu năng cao?
Dữ liệu AI có thể được giữ trên object storage quy mô lớn và truyền tới GPU mà không nhất thiết phải sao chép sang một tầng file storage hiệu năng cao riêng biệt.
Điều này có thể giảm số tầng lưu trữ, hạn chế di chuyển dữ liệu và đơn giản hóa vận hành. Object storage cũng mang lại metadata, versioning, tagging, multi-tenancy và khả năng mở rộng tới quy mô exabyte.
Lựa chọn kiến trúc cuối cùng vẫn cần dựa trên ứng dụng, cách truy cập dữ liệu, yêu cầu độ trễ và kết quả thử nghiệm thực tế.
Phù hợp với: IT, kiến trúc sư hạ tầng, đội AI.
Cách hoạt động và hiệu năng
4. GPUDirect for Object Storage hoạt động như thế nào?
Giải pháp tạo đường truyền dữ liệu trực tiếp hơn giữa lưu trữ và GPU bằng các cơ chế như peer-to-peer và RDMA, nhờ đó giảm số lần sao chép dữ liệu và giảm tải cho CPU.
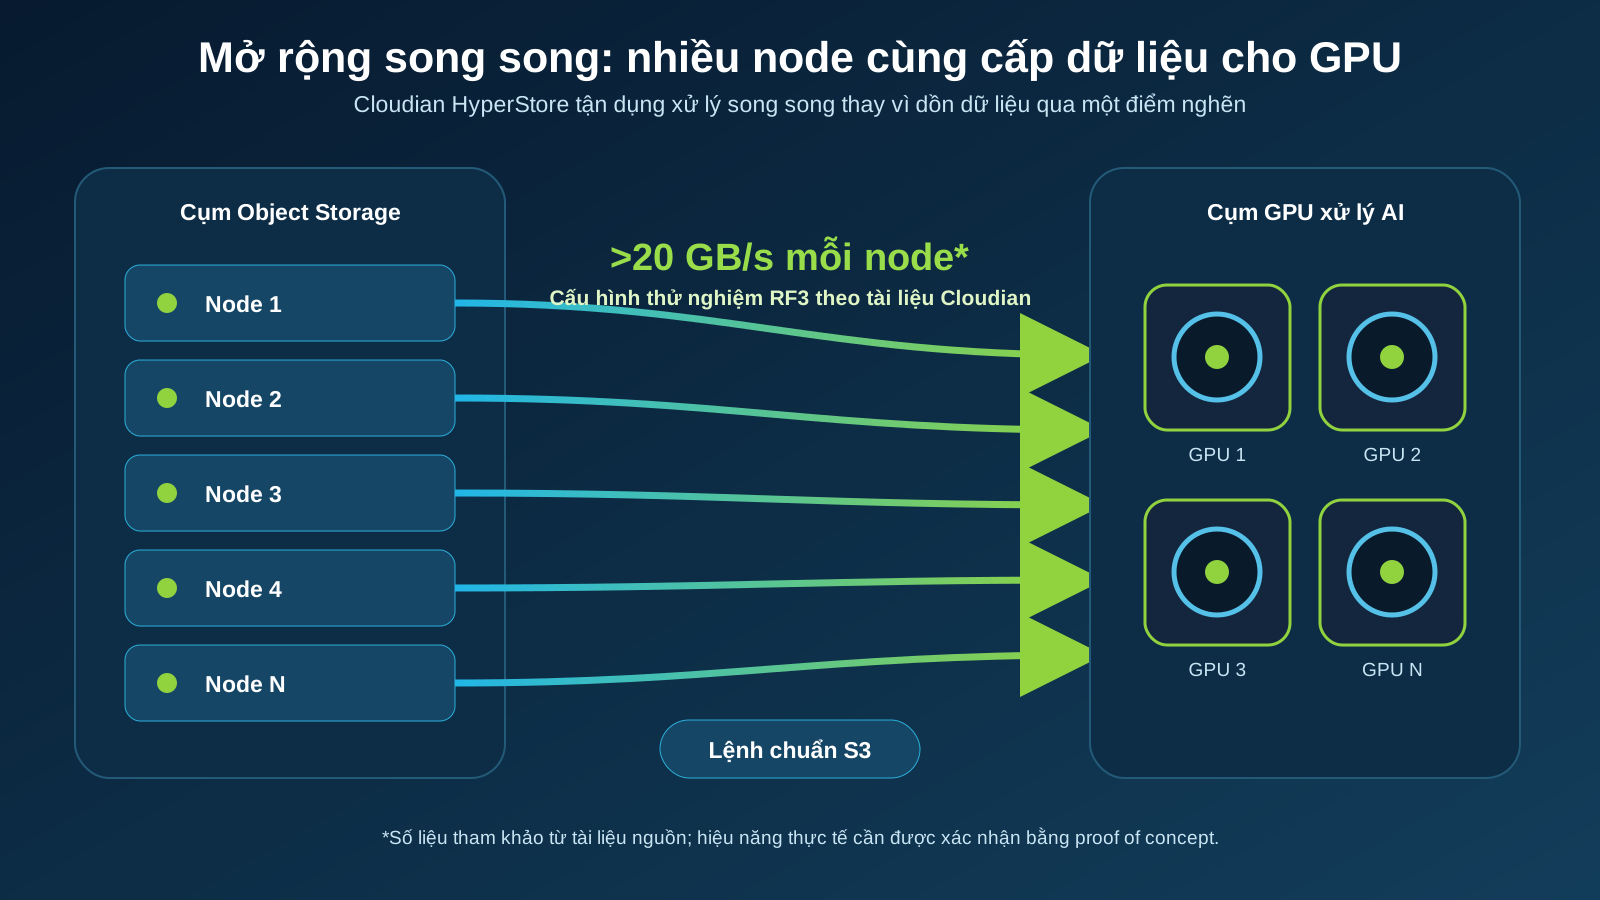
RDMA (Remote Direct Memory Access) cho phép thiết bị truy cập vùng nhớ từ xa với ít sự can thiệp của CPU hơn. Trong kiến trúc Cloudian, nhiều node có thể cấp dữ liệu song song cho GPU. Phần giao tiếp với object storage vẫn dùng các lệnh chuẩn S3.
GPUDirect không làm CPU “biến mất”. CPU vẫn điều phối nhiều hoạt động; lợi ích nằm ở việc giảm vai trò trung chuyển của CPU trên đường dữ liệu chính.
Phù hợp với: IT, kỹ sư hệ thống, đội AI/ML.
5. Cloudian HyperStore với GPUDirect có thể đạt hiệu năng bao nhiêu?
Theo tài liệu Cloudian, cấu hình thử nghiệm RF3 đạt hơn 20 GB/s trên mỗi node; mức 200 GB/s tương ứng với 10 node trong cấu hình được nêu.
RF3 (Replication Factor 3) nghĩa là dữ liệu được lưu thành ba bản sao để tăng khả năng bảo vệ và sẵn sàng. Các con số này là kết quả được nêu trong tài liệu nguồn, không phải phép đo mới tại thời điểm biên tập bài.
Không nên xem 20 GB/s/node hoặc 200 GB/s là mức bảo đảm cho mọi môi trường. Hãy chạy proof of concept với kích thước object, mô hình truy cập, mạng, GPU và workload gần với thực tế.
Phù hợp với: IT, đội AI, lãnh đạo kỹ thuật, presales.
6. Giải pháp đáp ứng nhu cầu lưu trữ của AI và machine learning ra sao?
Cloudian HyperStore cung cấp kho dữ liệu mở rộng tới quy mô exabyte, hỗ trợ truy cập đồng thời cao và giúp giảm nhu cầu di chuyển dữ liệu giữa nhiều tầng lưu trữ trong quy trình AI.
Khi dữ liệu được tập trung trên một nền tảng object storage có thể mở rộng, các nhóm có thể quản lý nhất quán hơn và giảm thời gian chờ do sao chép dữ liệu giữa kho dài hạn với hệ thống cấp dữ liệu cho GPU.
Phù hợp với: lãnh đạo dự án AI, IT, đội dữ liệu và AI/ML.
Giá trị kinh doanh, dữ liệu và bảo mật
7. Lợi ích chi phí của Cloudian HyperStore với GPUDirect là gì?
Lợi ích tiềm năng lớn nhất là giảm nhu cầu đầu tư và vận hành một tầng file storage hiệu năng cao riêng cho dữ liệu AI.
Kiến trúc ít tầng hơn có thể giảm chi phí thiết bị, quản trị, sao chép dữ liệu và vận hành. Việc giảm tải trung chuyển cho CPU cũng có thể góp phần giảm điện năng. Mức tiết kiệm thực tế cần được tính theo kiến trúc hiện tại, tăng trưởng dữ liệu, yêu cầu hiệu năng và tổng chi phí sở hữu.
Phù hợp với: lãnh đạo, tài chính, IT, sales/presales.
8. Cloudian HyperStore mang lại lợi ích bảo mật nào?
Theo tài liệu nguồn, GPUDirect for Object Storage không yêu cầu các thay đổi kernel do nhà cung cấp thực hiện như một số nền tảng file, qua đó có thể giảm bề mặt tấn công và đơn giản hóa quản trị.
Cloudian HyperStore còn cung cấp kiểm soát truy cập, mã hóa và S3 Object Lock. Object Lock giúp bảo vệ dữ liệu theo mô hình không thể sửa hoặc xóa trong thời gian lưu giữ đã đặt, hỗ trợ tăng khả năng chống ransomware.
Các tính năng này không thay thế chiến lược bảo mật tổng thể. Doanh nghiệp vẫn cần thiết kế quyền truy cập, quản lý khóa, phân tách mạng, giám sát và chính sách lưu giữ phù hợp.
Phù hợp với: bảo mật, tuân thủ, IT, lãnh đạo rủi ro.
9. Cloudian HyperStore giúp quản lý dữ liệu AI như thế nào?
HyperStore hỗ trợ metadata, versioning, object tags và multi-tenancy để các nhóm tổ chức, truy vết và chia sẻ dữ liệu trên cùng một nền tảng an toàn hơn.
- Metadata và tags: mô tả, phân loại và tìm dữ liệu theo dự án, nguồn, thời gian hoặc trạng thái xử lý.
- Versioning: lưu các phiên bản của object để hỗ trợ truy vết và khôi phục.
- Multi-tenancy: cho phép nhiều nhóm dùng chung hạ tầng nhưng vẫn tách biệt quyền truy cập.
Phù hợp với: đội dữ liệu, AI/ML, quản trị dữ liệu, IT.
Ngành và tình huống sử dụng
10. Ngành nào và use case nào phù hợp với giải pháp này?
Giải pháp phù hợp nhất với tổ chức có tập dữ liệu rất lớn, cần cấp dữ liệu nhanh cho GPU và muốn quản lý dữ liệu trên object storage có khả năng mở rộng.
Các ngành được tài liệu đề cập gồm ô tô, dịch vụ tài chính, y tế và cơ quan chính phủ. Use case tiêu biểu gồm generative AI, genomics, xe tự hành, hệ thống gợi ý, phân tích video và RAG.
Phù hợp với: lãnh đạo ngành, IT, đội AI/dữ liệu, sales/presales.
11. Doanh nghiệp chưa đưa AI vào production thì tại sao cần quan tâm ngay?
Vì dữ liệu là nền móng của AI; chuẩn bị kho dữ liệu sớm giúp tránh việc hợp nhất dữ liệu một cách vội vàng, tốn kém khi dự án AI trở nên cấp bách.
Tránh “AI Tax”
Giảm chi phí và thời gian xử lý dữ liệu phân mảnh khi cần triển khai AI nhanh.
Nâng chất lượng dữ liệu
Có thời gian bổ sung metadata, chuẩn hóa và xây dựng quy trình quản trị.
Triển khai nhanh hơn
Dữ liệu đã được tập trung và sẵn sàng hơn khi dự án AI bắt đầu.
Đầu tư sớm không đồng nghĩa phải mua toàn bộ hạ tầng ngay lập tức. Doanh nghiệp có thể bắt đầu bằng chiến lược dữ liệu, phân loại nguồn và thiết kế lộ trình mở rộng.
Phù hợp với: lãnh đạo, chiến lược dữ liệu, IT, tài chính.
12. Trong ngành ô tô, giải pháp hỗ trợ phát triển xe tự hành ra sao?
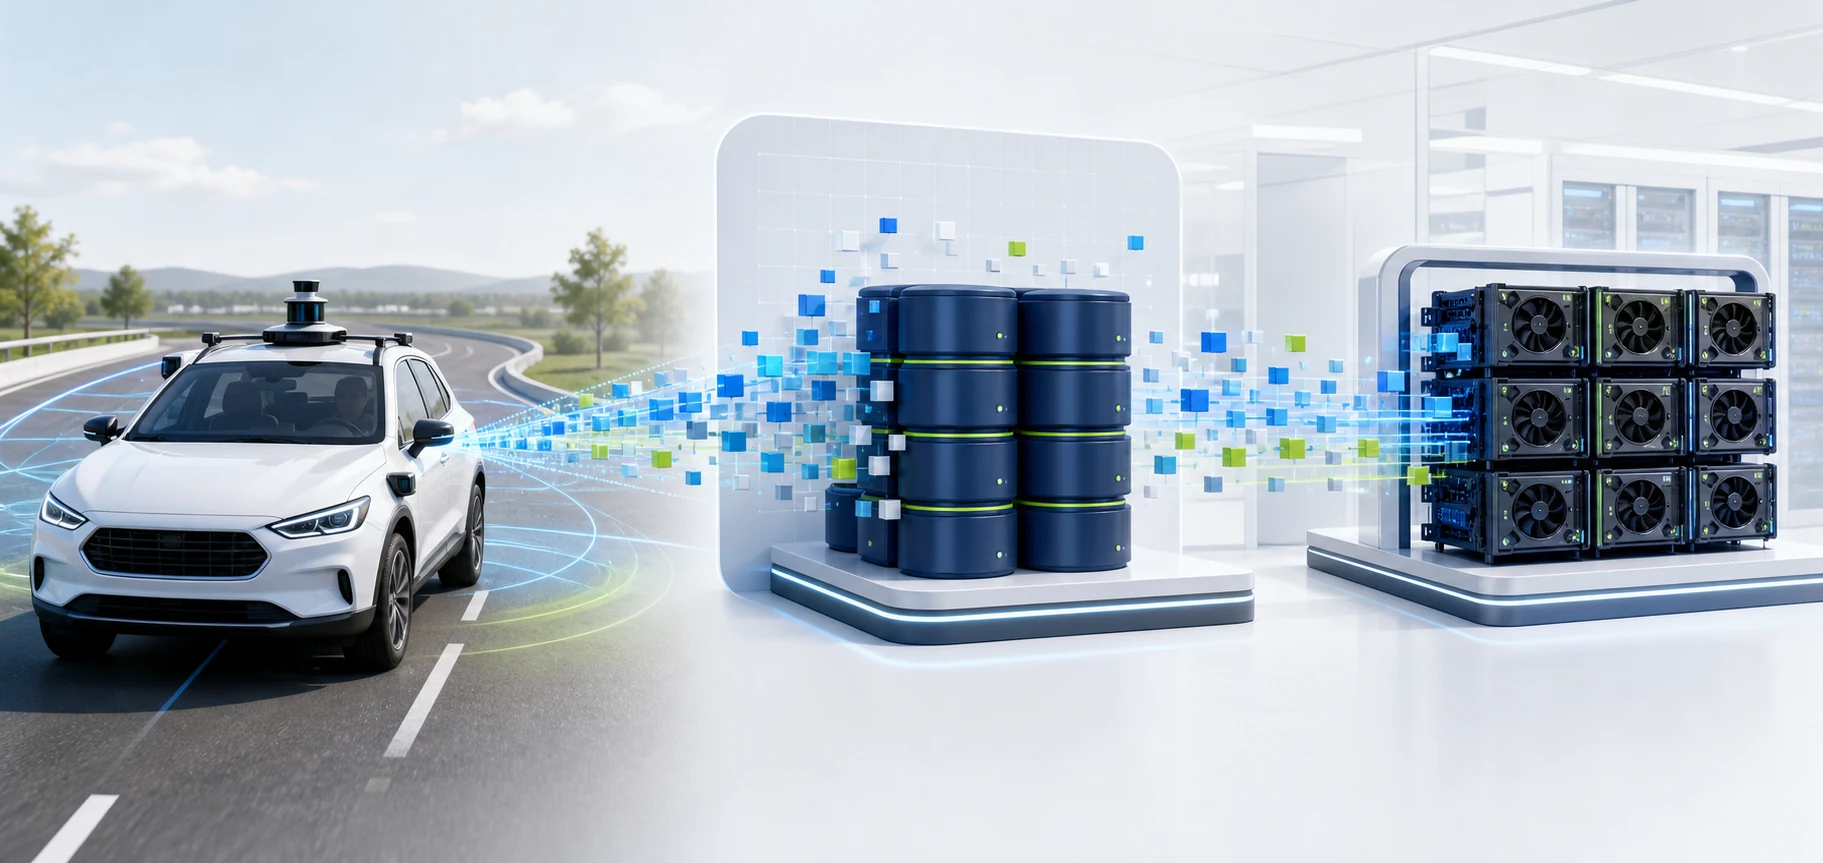
Cloudian HyperStore với GPUDirect có thể giúp lưu trữ và cấp nhanh lượng dữ liệu lớn từ phương tiện cho GPU dùng để huấn luyện và phân tích mô hình AI.
Theo tài liệu nguồn, một xe có thể tạo ra trung bình vài terabyte dữ liệu mỗi ngày. Việc giảm độ trễ và tăng thông lượng giúp rút ngắn vòng lặp huấn luyện – đánh giá mô hình và có thể giảm chi phí do bớt sao chép dữ liệu qua nhiều tầng.
Phù hợp với: ngành ô tô, đội AI/dữ liệu, IT, đối tác kênh.
Điều kiện triển khai và đánh giá
13. Phiên bản Cloudian HyperStore nào hỗ trợ GPUDirect?
Theo tài liệu nguồn, GPUDirect được hỗ trợ từ Cloudian HyperStore 8.1.2 trở lên.
Trước khi triển khai, hãy xác nhận thêm tính tương thích của phiên bản HyperStore, GPU, card mạng, driver, thư viện NVIDIA, thiết kế mạng và cấu hình S3 với Cloudian hoặc đối tác triển khai.
Phù hợp với: IT, kiến trúc sư giải pháp, presales.
14. Doanh nghiệp nên đánh giá những gì trước khi lựa chọn giải pháp?
Hãy bắt đầu từ workload, dữ liệu và mục tiêu kinh doanh thay vì chỉ so sánh tốc độ tối đa.
- Ứng dụng nào đang cần thông lượng cao và độ trễ thấp?
- Kế hoạch AI/ML trong 12-36 tháng tới là gì?
- Dữ liệu hiện nằm ở đâu và đang phân mảnh như thế nào?
- Chất lượng, metadata và tính nhất quán đã đủ cho AI chưa?
- Doanh nghiệp đã đầu tư GPU, mạng tốc độ cao hoặc RDMA chưa?
- Kích thước object và kiểu truy cập thực tế là gì?
- Yêu cầu bảo mật, lưu giữ, chủ quyền dữ liệu và ransomware ra sao?
- Tiêu chí thành công của PoC là GB/s, độ trễ, thời gian hoàn thành job, mức dùng CPU hay tổng chi phí?
Phù hợp với: mọi bên tham gia đánh giá giải pháp.
15. Bước tiếp theo hợp lý là gì?
Hãy chọn một workload AI đại diện và xây dựng proof of concept có tiêu chí đo lường rõ ràng.
Chuẩn bị tập dữ liệu mẫu, cấu hình GPU/mạng dự kiến, mức bảo vệ dữ liệu, yêu cầu S3 và chỉ số cần đo. Sau đó đối chiếu hiệu năng, mức dùng CPU, độ phức tạp vận hành và tổng chi phí với kiến trúc hiện tại hoặc phương án dùng file storage riêng.
Phù hợp với: lãnh đạo kỹ thuật, IT, AI/dữ liệu, presales.