Lưu trữ cho AI: chọn object, file hay block storage
Data / Storage • Lưu trữ cho AI • Object · File · Block
Lưu trữ cho AI hiếm khi là một hệ thống duy nhất: dữ liệu thô, dataset huấn luyện, checkpoint, cơ sở dữ liệu vector và KV cache có cách truy cập khác nhau, nên mỗi loại hợp với object, file hoặc block storage. Bài viết so sánh ba kiểu lưu trữ theo từng giai đoạn của pipeline AI và gợi ý cách ghép chúng trên storage server Supermicro.
1. Dữ liệu AI đi qua những chặng nào?
Trước khi hỏi “dùng storage gì”, nên vẽ lại đường đi của dữ liệu. Một dự án AI doanh nghiệp, từ trợ lý tri thức nội bộ (RAG) đến mô hình phân loại chứng từ, thường có năm chặng với kiểu truy cập rất khác nhau (Hình 1):
- Thu thập và lưu trữ gốc: tài liệu, log, ảnh, bản ghi giao dịch đổ về liên tục, dung lượng tăng nhanh, cần giữ lâu và gắn metadata.
- Chuẩn bị dữ liệu: làm sạch, gán nhãn, chia nhỏ văn bản, tạo embedding; nhiều công cụ đọc ghi cùng lúc.
- Huấn luyện / fine-tune: đọc tuần tự dataset với thông lượng cao, ghi checkpoint định kỳ theo từng đợt lớn.
- Suy luận và RAG: nạp mô hình, truy vấn cơ sở dữ liệu vector, lưu KV cache; ưu tiên độ trễ thấp.
- Lưu trữ dài hạn: phiên bản mô hình, dataset đã dùng, nhật ký để kiểm toán và tái lập kết quả.
Từ bức tranh này có thể thấy: không có một kiểu lưu trữ “tốt nhất cho AI”. Câu hỏi đúng là chặng nào dùng kiểu nào, và lớp nào là kho chính để tránh sao chép dữ liệu qua lại giữa nhiều hệ thống.
2. Object, file và block storage khác nhau ở đâu?
Ba kiểu lưu trữ khác nhau ở cách ứng dụng “nhìn thấy” dữ liệu (Hình 2): block trình ra một volume để máy chủ tự định dạng như ổ cục bộ; file trình ra cây thư mục mà nhiều máy cùng mount qua NFS, SMB hoặc file system song song; object lưu mỗi đối tượng kèm khóa và metadata, truy cập qua API S3 trong một không gian phẳng mở rộng tới petabyte.
| Tiêu chí | Block | File | Object |
|---|---|---|---|
| Cách truy cập | Volume qua NVMe/TCP, iSCSI, FC | Thư mục qua NFS, SMB, file system song song | API S3 qua HTTP, có thể tăng tốc bằng RDMA |
| Dùng chung | Thường một máy hoặc một pod mỗi volume | Nhiều máy cùng mount | Mọi ứng dụng có quyền truy cập bucket |
| Mở rộng | Theo cụm, theo volume | Tùy kiến trúc NAS hoặc file system song song | Thêm node để tăng cả dung lượng và thông lượng |
| Metadata | Không có ở tầng lưu trữ | Thuộc tính file cơ bản | Metadata tùy biến cho từng đối tượng |
| Tải AI hợp nhất | Vector DB, cơ sở dữ liệu, VM, volume cho container, KV cache | Công cụ cần POSIX, thư mục làm việc chung, một số job huấn luyện | Data lake, dataset, checkpoint, kho tài liệu RAG, lưu dài hạn |
3. Object storage: kho dữ liệu chính cho AI
Với phần lớn doanh nghiệp, object storage tương thích S3 là lựa chọn hợp lý cho kho dữ liệu chính của AI. Lý do là các framework và công cụ dữ liệu phổ biến đều đọc ghi S3, dung lượng mở rộng bằng cách thêm node, và metadata giúp quản lý phiên bản dataset, quyền truy cập, vòng đời dữ liệu. Bài object storage cho AI: bài học từ Meta cho thấy cách các hệ thống quy mô lớn dùng object làm nền.
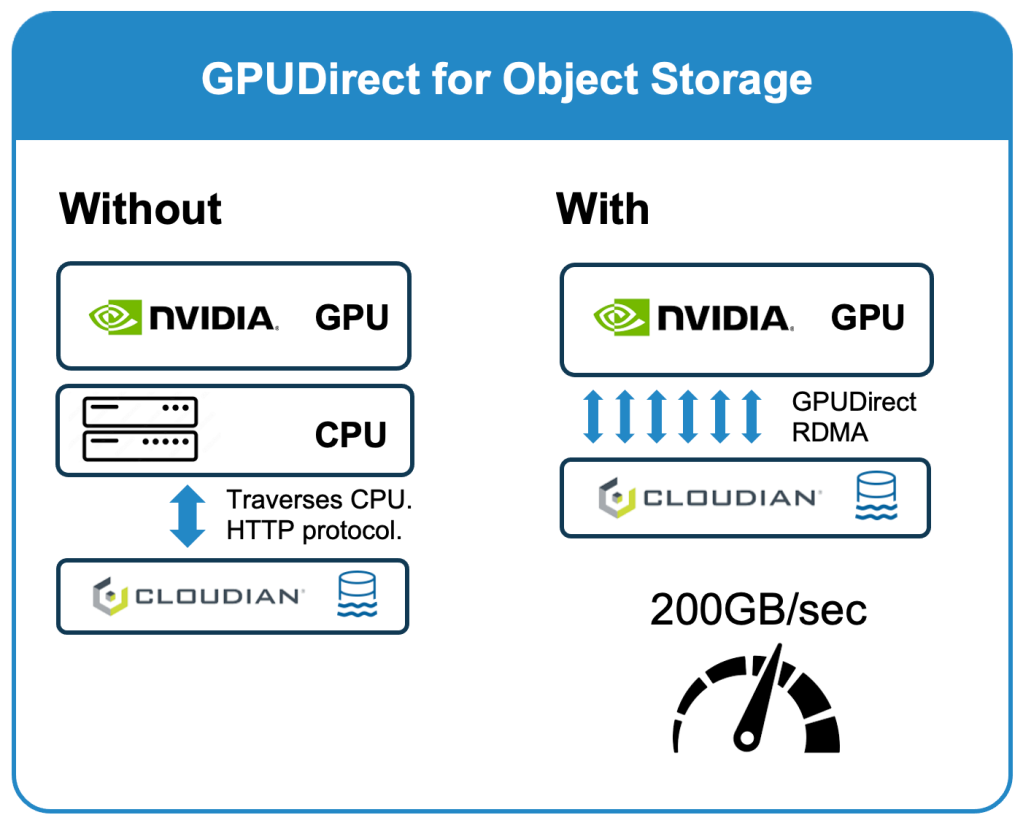
Điểm yếu truyền thống của object storage là tốc độ: dữ liệu đi qua HTTP và CPU của máy chủ GPU trước khi tới bộ nhớ GPU. Cloudian HyperStore giải quyết điểm này bằng RDMA cho S3 và hỗ trợ NVIDIA GPUDirect for Object Storage, cho phép chuyển dữ liệu trực tiếp giữa node lưu trữ và máy chủ GPU (Ảnh 1). Theo Cloudian, cách làm này đạt “200+ GB/s” thông lượng duy trì và giảm 45% mức dùng CPU trên máy chủ GPU, không cần sửa đổi kernel. Đây là số liệu hãng công bố, nên kiểm chứng bằng PoC.
Khi kho S3 đủ nhanh để cấp dữ liệu trực tiếp cho GPU, doanh nghiệp có thể bỏ bớt một lớp file storage trung gian và tránh việc chép dataset qua lại giữa các tầng. Chi tiết kiến trúc xem thêm ở bài data lake AI với Cloudian trên storage server Supermicro và 15 câu hỏi về Cloudian HyperStore với NVIDIA GPUDirect; bài toán chi phí ở quy mô petabyte có trong bài chi phí 1 PB object storage.
4. File storage: khi ứng dụng cần thư mục dùng chung
File storage vẫn có chỗ đứng trong hạ tầng AI. Nhiều công cụ khoa học dữ liệu, notebook, phần mềm xử lý ảnh y tế hay video chỉ làm việc với đường dẫn file, và một số job huấn luyện được viết để đọc dataset từ thư mục. Khi nhiều máy chủ GPU cần cùng một không gian tên, NFS hoặc file system song song là cách ít phải sửa ứng dụng nhất.
Về tốc độ, NVIDIA GPUDirect Storage tạo đường DMA trực tiếp giữa bộ nhớ GPU và storage, hỗ trợ NVMe cục bộ, NVMe-oF và các file system mạng hoặc phân tán. Tài liệu NVIDIA cho biết API cuFile phù hợp nhất với các luồng truyền dữ liệu khối lớn, và ứng dụng phải gọi cuFile thì mới dùng được đường đi trực tiếp này.
Với doanh nghiệp cần một hệ thống vừa NAS vừa SAN, dòng unified storage như Infortrend EonStor GS hỗ trợ cả môi trường file và block. Bài lưu trữ cho AI với Infortrend EonStor GS 5000U đã phân tích riêng hướng này.
5. Block storage: độ trễ thấp cho cơ sở dữ liệu, VM và KV cache
Ở chặng suy luận và RAG, nhiều thành phần cần block storage: cơ sở dữ liệu vector, cơ sở dữ liệu nghiệp vụ cấp ngữ cảnh cho mô hình, máy ảo và volume cho container trên Kubernetes. Các tải này đọc ghi ngẫu nhiên, khối nhỏ và nhạy với độ trễ, điều mà object và phần lớn file storage không tối ưu.
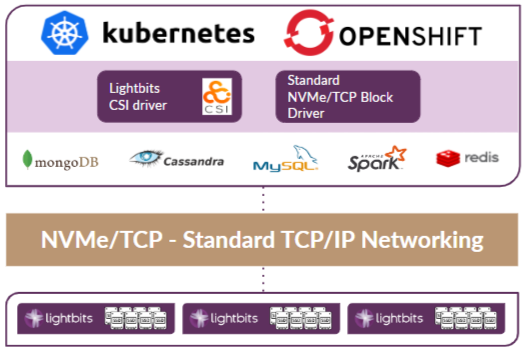
Lightbits là block storage định nghĩa bằng phần mềm, tách rời khỏi máy chủ ứng dụng, chạy giao thức NVMe over TCP trên mạng Ethernet tiêu chuẩn và không đòi hỏi sửa ứng dụng. Theo trang giải pháp chung của Supermicro và Lightbits, một cụm Lightbits cần tối thiểu 3 node và tích hợp với Kubernetes, OpenShift, OpenStack; trang của Lightbits liệt kê thêm môi trường VMware và Proxmox VE (Ảnh 2). CSC đã phân tích cách dùng này ở bài Lightbits cho container trên Supermicro.
KV cache là trường hợp đáng chú ý. Khi ngữ cảnh dài và nhiều người dùng, KV cache tràn khỏi bộ nhớ GPU và cần một tầng lưu trữ nhanh bên dưới. Lightbits giới thiệu Inferra, engine KV cache tích hợp với vLLM, SGLang và TensorRT; cách phân tầng KV cache từ HBM tới S3 có trong bài phân tầng lưu trữ KV cache cho suy luận AI.
6. Chọn lưu trữ cho AI theo từng tải
Ba câu hỏi dưới đây đủ để xếp phần lớn dữ liệu AI vào đúng kiểu lưu trữ (Hình 3):
| Dữ liệu / tải | Kiểu chính | Lý do | Giải pháp tham chiếu |
|---|---|---|---|
| Data lake, tài liệu gốc cho RAG | Object | Dung lượng lớn, metadata, phân quyền theo bucket | Cloudian HyperStore |
| Dataset huấn luyện, checkpoint | Object (hoặc file nếu framework yêu cầu) | Đọc tuần tự thông lượng cao; ghi theo đợt lớn | Cloudian với RDMA cho S3; file system có GPUDirect Storage |
| Vùng làm việc chung, notebook | File | Ứng dụng cần đường dẫn và quyền POSIX | NAS / unified storage, CephFS |
| Vector DB, cơ sở dữ liệu, VM | Block | Truy cập ngẫu nhiên, nhạy độ trễ | Lightbits NVMe/TCP |
| KV cache tràn khỏi GPU | Block nhanh + object | Tầng nóng cần độ trễ thấp, tầng ấm cần dung lượng | Lightbits Inferra; Cloudian cho tầng S3 |
| Phiên bản mô hình, lưu dài hạn | Object | Giữ lâu, chi phí thấp, có thể khóa bất biến | Cloudian HyperStore |
Một lưu ý về vận hành: càng nhiều hệ thống, đội ngũ càng nhiều việc. Ceph là ví dụ một nền tảng cung cấp cả object, block và file trong một hệ thống thống nhất, phù hợp khi đội ngũ đã quen vận hành Ceph. Với tải AI cần hiệu năng cao ở từng lớp, cách phổ biến là một kho object làm nền và một lớp block NVMe cho tải nhạy độ trễ, file storage chỉ thêm khi ứng dụng thực sự cần.
7. Storage server Supermicro cho lớp object và lớp block
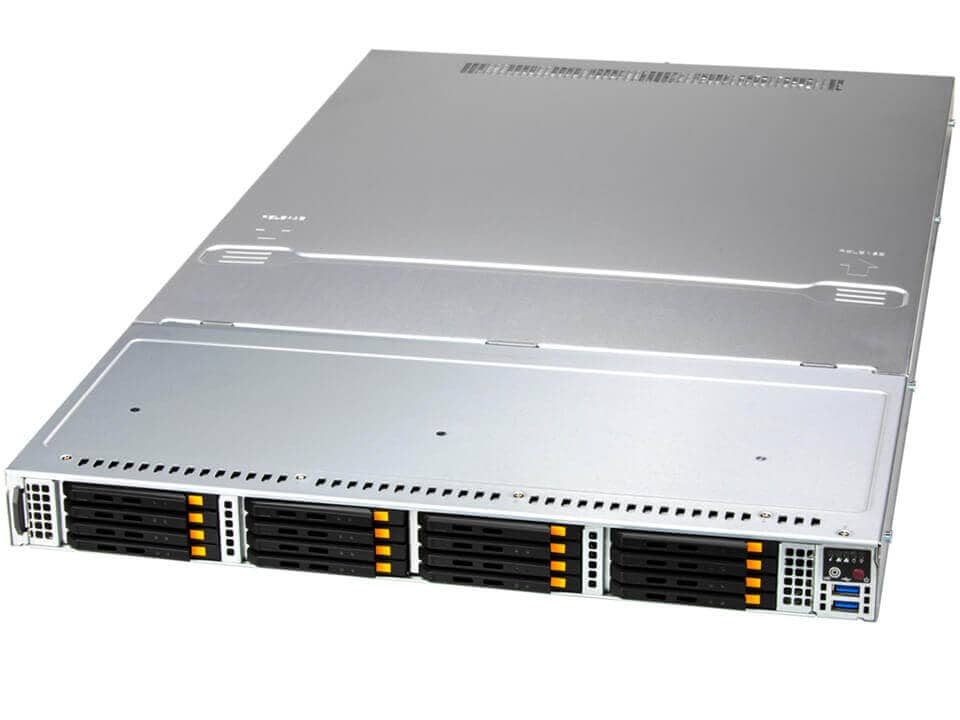
Hai lớp chính ở trên có yêu cầu phần cứng khác nhau. Lớp object cần nhiều khay ổ dung lượng lớn trên mỗi đơn vị rack; lớp block cần ổ NVMe, CPU và mạng đủ mạnh để giữ độ trễ thấp. Kiến trúc tham chiếu ở Hình 4 ghép hai lớp này với cụm máy chủ GPU Supermicro qua mạng Ethernet; thiết kế mạng chi tiết xem bài mạng cho cụm máy chủ GPU.
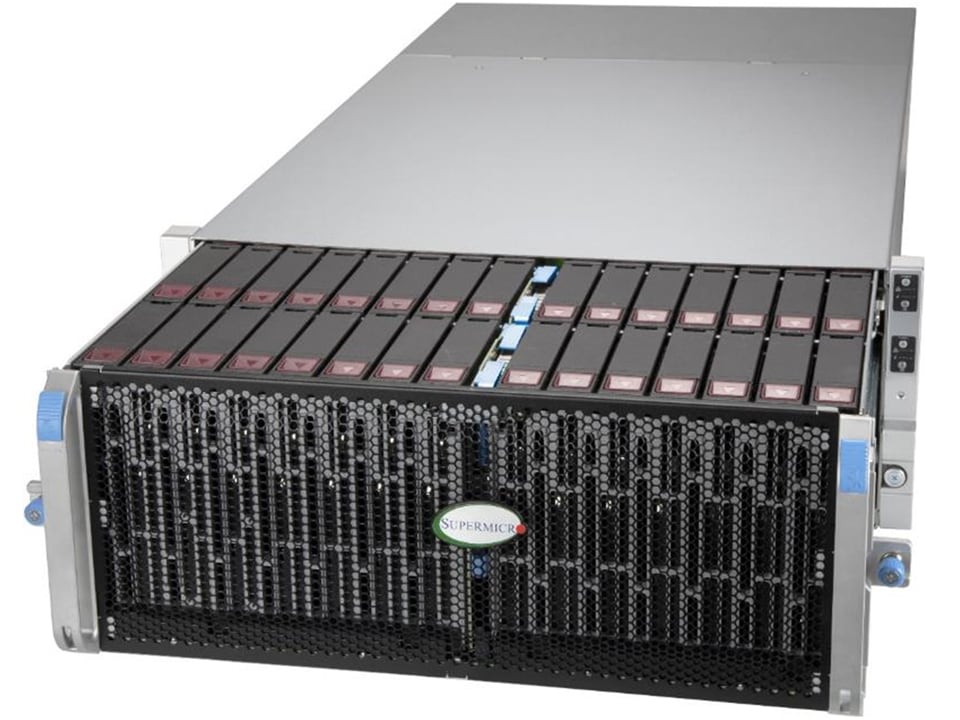
SSG-542B-DE1CR90 là storage server top-loading 4U gồm 2 node, mỗi node 90 khay 3,5″/2,5″ SAS/SATA nạp từ trên, một CPU Intel Xeon 6700/6500 và tới 2 TB bộ nhớ DDR5. Supermicro liệt kê ứng dụng gồm AI/ML, kho nội dung và lưu trữ ảnh y tế, phù hợp vai trò kho object dung lượng lớn. SSG-121E-NE316R là máy chủ lưu trữ all-flash 1U với 16 khay E3.S NVMe, hai CPU Intel Xeon Scalable thế hệ 4/5, có tên trong danh sách máy chủ Supermicro dùng cho Lightbits.
8. Câu hỏi thường gặp
Lưu trữ cho AI nên chọn object, file hay block storage?
Thường cần kết hợp. Object storage tương thích S3 làm kho chính cho data lake, dataset, checkpoint và bản lưu dài hạn; block storage NVMe cho vector DB, cơ sở dữ liệu, VM và KV cache; file storage chỉ thêm khi ứng dụng bắt buộc dùng thư mục chung theo chuẩn POSIX.
Object storage có đủ nhanh để cấp dữ liệu cho máy chủ GPU không?
Với RDMA cho S3 và GPUDirect cho object storage, dữ liệu được chuyển trực tiếp qua RDMA từ node lưu trữ tới máy chủ GPU, giảm tải đáng kể cho CPU. Cloudian công bố thông lượng duy trì trên 200 GB/s và giảm 45% mức dùng CPU máy chủ GPU; đây là số liệu hãng, nên kiểm chứng bằng PoC với dataset thật.
Khi nào cần block storage NVMe/TCP cho AI?
Khi tải đọc ghi ngẫu nhiên, khối nhỏ và nhạy độ trễ: cơ sở dữ liệu vector cho RAG, cơ sở dữ liệu nghiệp vụ, máy ảo, volume cho container trên Kubernetes và tầng KV cache tràn khỏi bộ nhớ GPU. NVMe/TCP chạy trên Ethernet tiêu chuẩn nên không cần mạng lưu trữ riêng.
Đã có object storage S3 thì còn cần file storage không?
Chỉ khi có ứng dụng hoặc framework bắt buộc đọc ghi theo đường dẫn file và nhiều máy cần dùng chung một thư mục. Khi đó nên giới hạn file storage ở vùng làm việc, còn dữ liệu gốc và dataset đã chốt vẫn đặt ở kho object.
Có hệ thống nào cung cấp cả object, file và block không?
Có. Ceph cung cấp cả ba trong một hệ thống thống nhất, và các dòng unified storage như Infortrend EonStor GS hỗ trợ cả môi trường file và block. Lựa chọn phụ thuộc yêu cầu hiệu năng của từng lớp và khả năng vận hành của đội ngũ.
Đọc thêm về lưu trữ cho AI