Data lake AI với Cloudian trên storage server Supermicro
Data/Storage • Data lake AI • Object storage
Data lake AI với Cloudian HyperStore trên storage server Supermicro là cách nhiều doanh nghiệp gom dữ liệu thô, dữ liệu huấn luyện và tài liệu cho RAG về một kho S3 duy nhất, chạy tại chỗ, mở rộng theo từng node. Bài viết đi qua kiến trúc tham chiếu hai tầng (flash và HDD), cách chọn máy, cách tính dung lượng dùng được và các điểm cần PoC trước khi triển khai.
1. Data lake AI cần gì từ tầng lưu trữ?
Data lake (hồ dữ liệu, khác với lakehouse ở cách quản lý bảng và giao dịch, xem phân biệt lakehouse và data lake) lưu dữ liệu ở định dạng gốc và cho phép nhiều công cụ phân tích, huấn luyện và suy luận cùng truy cập. Với dự án AI, cùng một kho dữ liệu phải phục vụ ba kiểu tải rất khác nhau:
Ghi liên tục
Log, ảnh camera, chứng từ quét, bản xuất từ cơ sở dữ liệu đổ về hằng ngày. Cần dung lượng lớn, giá trên mỗi TB thấp và mở rộng không gián đoạn.
Đọc lặp lại
Dataset được GPU đọc nhiều epoch, checkpoint được ghi định kỳ. Cần thông lượng đọc cao để GPU không phải chờ.
Truy xuất tri thức
Tài liệu nội bộ được chia nhỏ, tạo embedding, đưa vào vector database. Cần phân quyền chặt và độ trễ ổn định.
Thêm vào đó là yêu cầu quản trị: nhiều phòng ban dùng chung, dữ liệu nhạy cảm phải được mã hóa, một số bộ dữ liệu phải giữ nguyên không sửa được trong thời hạn lưu trữ. Đây là lý do object storage chuẩn S3 trở thành lớp nền phổ biến của data lake AI: API thống nhất, mở rộng theo chiều ngang, siêu dữ liệu đi kèm từng object.
2. Cloudian HyperStore: object storage S3 làm nền cho data lake
Cloudian HyperStore là phần mềm object storage tương thích S3 chạy trên máy chủ tiêu chuẩn; CSC Distribution là nhà phân phối duy nhất của Cloudian tại Việt Nam và khu vực APAC. Những đặc điểm liên quan trực tiếp tới data lake AI, theo tài liệu chính thức của Cloudian:
- S3 native: Cloudian mô tả HyperStore có mức tương thích S3 API cao và dùng chính AWS S3 SDK, nên Spark job, script Python hay công cụ ETL viết cho S3 thường chạy được mà không phải sửa nhiều. Đây cũng là lý do nhiều tổ chức chuyển từ MinIO sang Cloudian mà ít phải sửa ứng dụng.
- Kiến trúc peer-to-peer, shared-nothing: không có metadata server hay head node riêng; node nào cũng phục vụ I/O, thông lượng tăng cùng dung lượng khi thêm node.
- Bảo vệ dữ liệu theo bucket: chọn replication hoặc erasure coding cho từng bucket, phân tán qua node, rack hoặc nhiều site.
- Object Lock (WORM): khóa object không cho sửa, xóa trong thời hạn lưu giữ, dùng cho dữ liệu cần tuân thủ hoặc chống ransomware. Cohasset Associates đánh giá HyperStore ở chế độ Object Lock Compliance đáp ứng SEC 17a-4(f), FINRA 4511(c) và CFTC 1.31.
- Multi-tenancy và QoS: mỗi tenant có namespace riêng; giới hạn thông lượng và số request theo tenant; đo dung lượng theo người dùng để phân bổ chi phí; mã hóa dữ liệu khi truyền và khi lưu.
- S3 Select: theo HyperStore Admin Guide 8.2, dịch vụ S3 hỗ trợ S3 Select trên object CSV, JSON và Parquet, giúp lọc dữ liệu ngay tại kho thay vì kéo cả file về.
Cloudian công bố tích hợp với các nền tảng phân tích dùng S3 làm kho ngoài như Snowflake, Teradata Vantage, Vertica (Eon Mode), SQL Server (external tables) và Dremio. Nghĩa là cùng một bản dữ liệu vừa phục vụ BI, vừa phục vụ huấn luyện mô hình, thay vì sao chép sang nhiều hệ thống (Hình 1).
3. Kiến trúc hai tầng: flash cho dữ liệu nóng, HDD cho dung lượng
Không phải dữ liệu nào trong data lake cũng cần tốc độ như nhau. Dữ liệu thô nhiều năm chủ yếu nằm yên, còn dataset đang huấn luyện và chỉ mục RAG được đọc liên tục. Cách làm hợp lý là tách thành hai nhóm node với hai mục đích (Hình 2):
- Tầng dung lượng (HDD): storage server mật độ cao, ổ 3,5″ SAS/SATA, chứa dữ liệu thô, lịch sử, bản lưu trữ và bucket có Object Lock. Tối ưu chi phí trên mỗi TB (tham khảo cách tính chi phí 1 PB object storage).
- Tầng hiệu năng (all-flash NVMe): storage server NVMe chứa dataset đang dùng, checkpoint, dữ liệu nguồn cho RAG. Nối mạng tốc độ cao tới cụm GPU (xem mạng cho cụm máy chủ GPU). Với suy luận, tầng này còn có thể giữ KV cache, như trong bài phân tầng lưu trữ KV cache.
Hai tầng có thể là hai cụm HyperStore hoặc hai nhóm bucket với chính sách lưu trữ khác nhau, tùy quy mô và yêu cầu vận hành. Việc chuyển dữ liệu giữa hai tầng do pipeline dữ liệu điều khiển (chuẩn bị dataset trước mỗi đợt huấn luyện, đẩy về tầng dung lượng khi xong). Phương án cụ thể nên được chốt trong bước thiết kế cùng đội ngũ triển khai.
Để quyết định một bộ dữ liệu nằm ở tầng nào, có thể dùng cây quyết định đơn giản dưới đây (Hình 3).
4. Chọn storage server Supermicro cho Cloudian HyperStore
Trang software-defined storage của Supermicro ghi rằng Cloudian HyperStore đã được chứng nhận trên nhiều dòng storage server Supermicro; trang giải pháp Supermicro–Cloudian giới thiệu nền tảng dữ liệu sẵn sàng cho AI kết hợp hai hãng, trong đó có cả ba máy chủ Supermicro dưới đây. Ba dòng máy này bao phủ phần lớn nhu cầu data lake:
 chạy trên storage server Supermicro
| Vai trò | Model | Khung máy và ổ | CPU, bộ nhớ | Mạng, nguồn |
|---|---|---|---|---|
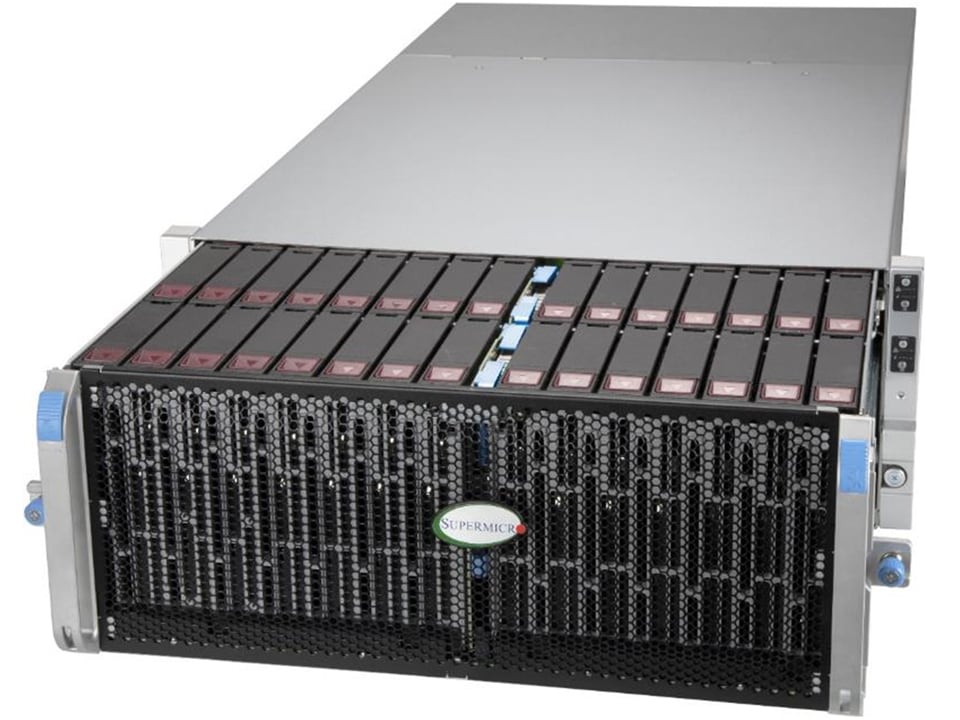
| Tầng dung lượng, quy mô PB | SSG-542B-DE1CR90 | 4U, 2 node, 90 khay 3,5″ SAS/SATA hot-swap nạp từ trên (top-loading), PCIe 5.0 | Mỗi node 1× Intel Xeon 6700/6500, tới 2 TB DDR5-6400 | Mỗi node 3× PCIe 5.0 x16 + 1× x8 cho card mạng; 2× nguồn 2600 W Titanium |
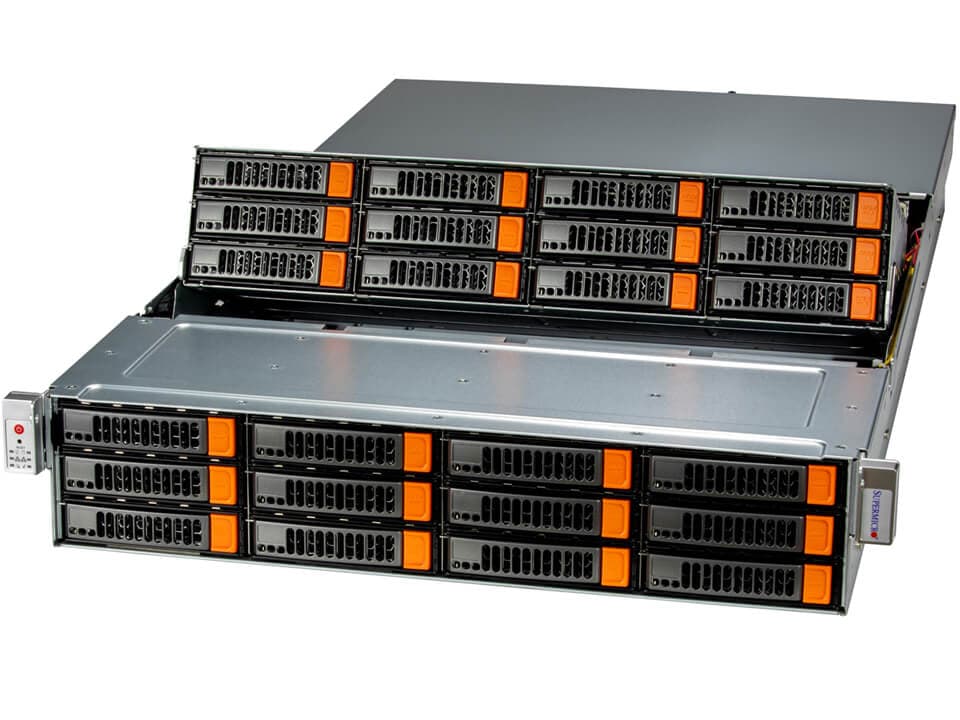
| Tầng dung lượng, khởi đầu vừa | SSG-521E-E1CR24L | 2U, 24 khay 3,5″ SAS/SATA hot-swap (12 phía trước, 12 nạp từ trên) | 1× Intel Xeon Scalable thế hệ 4/5, tới 4 TB DDR5-5600 | AIOM + khe PCIe 5.0; 2× nguồn 1600 W Titanium |
| Tầng hiệu năng all-flash | ASG-1115S-NE316R | 1U, 16 khay E3.S NVMe PCIe 5.0 hot-swap | 1× AMD EPYC 9004/9005, 24 khe DIMM (tới 9 TB với EPYC 9005, 2DPC) | 2 khe AIOM (OCP 3.0) + 2× PCIe 5.0 x16; 2× nguồn 1600 W Titanium |
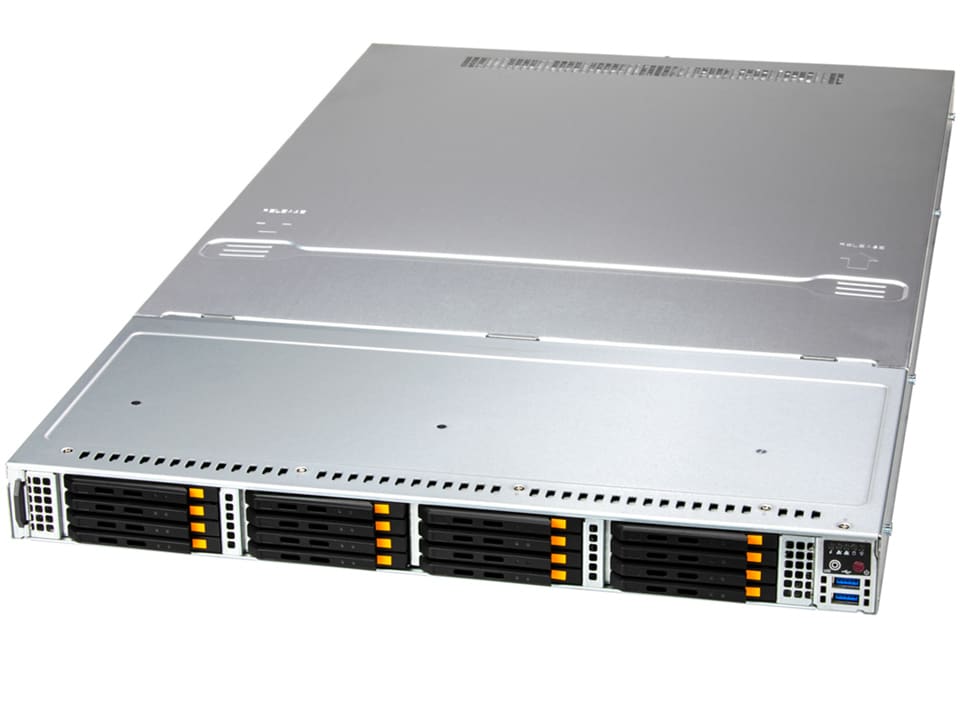
Ba điểm cần lưu ý khi chọn máy:
- Số node và miền lỗi quan trọng hơn số khay. Erasure coding phân mảnh dữ liệu theo node, nên một cụm nhiều node vừa phải thường an toàn và cân bằng tải hơn một vài node rất lớn. SSG-542B-DE1CR90 đặt hai node trong một khung 4U; hai node này dùng chung khung và nguồn, nên khi thiết kế EC cần coi mỗi khung là một miền lỗi (failure domain).
- Mạng là phần phải chọn thêm. SSG-542B-DE1CR90 không có cổng mạng tích hợp, card mạng được chọn theo thiết kế (thường 25–100 GbE cho tầng dung lượng, 100–400 GbE cho tầng flash nối GPU).
- Bộ nhớ và CPU theo số ổ. Mỗi ổ, mỗi object đều cần CPU và RAM cho erasure coding và siêu dữ liệu. Cấu hình RAM, CPU, ổ khởi động và ổ metadata nên lấy theo khuyến nghị sizing của Cloudian cho phiên bản HyperStore triển khai.
5. Đưa dữ liệu từ data lake tới GPU và RAG
Khi data lake phục vụ trực tiếp cụm GPU, câu hỏi chuyển từ “chứa được bao nhiêu” sang “cấp dữ liệu nhanh tới đâu”. Cloudian có ba hướng đã công bố:
- S3 qua RDMA (NVIDIA GPUDirect for Object Storage): (giải thích chi tiết trong RDMA S3 và 15 câu hỏi về Cloudian GPUDirect) dữ liệu đi thẳng giữa storage và bộ nhớ GPU, giảm tải CPU máy chủ GPU. Trong thông cáo 11/2024, Cloudian công bố hơn 200 GB/s từ một hệ thống trong thử nghiệm GOSBench và giảm 45% tải CPU. Trong thông cáo này, Supermicro cho biết tích hợp áp dụng cho dòng appliance HyperStore xây dựng trên hệ thống Supermicro.
- NVIDIA-Certified Storage: HyperStore 8.2.6 đạt mức Foundation của chương trình NVIDIA-Certified Storage (03/2026), kiểm chứng với tới 128 GPU.
- HyperScale AI Data Platform (AIDP): hệ thống đóng sẵn gồm object storage, GPU và giao diện hỏi đáp bằng ngôn ngữ tự nhiên, tích hợp vector database Milvus cho RAG (xem thêm HyperScale AI Data Platform). Cloudian công bố tới 35 GB/s đọc trên mỗi node và hơn 1 TB/s đọc trong một rack; bản 1.1 (06/2026) được kiểm chứng trên nền máy chủ GPU NVIDIA-Certified của Supermicro.
Các con số trên là số liệu hãng công bố trong điều kiện thử nghiệm của hãng. Thông lượng thực tế phụ thuộc mạng, kích thước object, số client và định dạng dữ liệu, nên cần đo bằng PoC với chính pipeline huấn luyện hoặc RAG của doanh nghiệp.
6. Lộ trình triển khai data lake AI 5 bước
- Khảo sát dữ liệu: cùng với kế hoạch máy chủ GPU Supermicro nếu có; nguồn, khối lượng hiện tại, tốc độ tăng 3 năm, kích thước object điển hình, yêu cầu lưu giữ và phân quyền.
- Thiết kế: số tầng, số node, chính sách EC/replication cho từng nhóm bucket, mạng, tenant và Object Lock.
- PoC: chạy thử ingest, đọc dataset từ GPU, truy vấn từ công cụ phân tích; đo thông lượng và thời gian tái tạo khi rút một node.
- Triển khai và tích hợp: lắp đặt máy, cài HyperStore, kết nối IAM/LDAP, giám sát, pipeline dữ liệu.
- Vận hành và mở rộng: theo dõi dung lượng, thêm node theo kế hoạch, kiểm tra định kỳ khả năng khôi phục.
7. Câu hỏi thường gặp
Data lake AI khác gì kho lưu trữ file thông thường?
Data lake lưu dữ liệu ở định dạng gốc trong một namespace chung để nhiều công cụ phân tích, huấn luyện và RAG cùng truy cập qua API chuẩn như S3. Kho file thông thường thường gắn với từng ứng dụng, khó mở rộng lên quy mô petabyte và khó phân quyền theo nhiều tenant.
Vì sao chạy Cloudian HyperStore trên storage server Supermicro?
HyperStore là phần mềm chạy trên máy chủ tiêu chuẩn và đã được chứng nhận trên nhiều dòng storage server Supermicro. Doanh nghiệp chọn được máy chủ Supermicro có mật độ ổ, CPU, mạng phù hợp từng tầng (HDD mật độ cao hoặc all-flash NVMe) và mở rộng bằng cách thêm node.
Nên dùng erasure coding hay replication cho data lake?
Erasure coding như 4+2 dùng được khoảng 67% dung lượng thô và chịu được mất 2 mảnh, phù hợp phần lớn dữ liệu của data lake. Replication 3 bản chỉ dùng được khoảng 33% dung lượng thô, thường dành cho bucket nhỏ hoặc nhiều object rất nhỏ. Cloudian cho phép chọn theo từng bucket.
Data lake trên Cloudian có cấp dữ liệu đủ nhanh cho GPU không?
Cloudian hỗ trợ S3 qua RDMA (GPUDirect for Object Storage) và đạt NVIDIA-Certified Storage mức Foundation. Với cụm GPU lớn nên thêm tầng all-flash NVMe và mạng 100–400 GbE, rồi đo thông lượng thực tế bằng PoC với pipeline của doanh nghiệp.
Đọc thêm về lưu trữ cho AI
- Chi phí 1 PB object storage: Ceph RF3 hay Cloudian?
- Cloudian HyperStore với NVIDIA GPUDirect: 15 câu hỏi thường gặp
- Phân tầng lưu trữ KV cache cho suy luận AI: từ HBM đến S3
- Máy chủ Supermicro cho Proxmox VE và Ceph: chọn thế nào
- Chọn máy chủ GPU Supermicro cho suy luận GenAI
- CSC Distribution trở thành nhà phân phối giải pháp và dịch vụ của Supermicro tại Việt Nam