Chia sẻ máy chủ GPU Supermicro cho nhiều phòng ban với Rafay
Hạ tầng AI • GPU PaaS • Máy chủ GPU Supermicro
Chia sẻ máy chủ GPU cho nhiều phòng ban chỉ hiệu quả khi có một lớp nền tảng phân quyền, đặt hạn mức, cấp phát tự phục vụ và đo được ai dùng bao nhiêu. Bài viết trình bày cách dựng mô hình GPU PaaS nội bộ cho hạ tầng AI với Rafay GPU PaaS trên máy chủ GPU Supermicro: tổ chức tenant và quota, chọn cách chia GPU (MIG hay time-slicing), luồng tự phục vụ, chargeback và cấu hình phần cứng gợi ý.
1. Vì sao chia sẻ máy chủ GPU giữa các phòng ban dễ lãng phí?
Ở nhiều ngân hàng và trường đại học, máy chủ GPU đầu tiên thường được mua cho một dự án. Sau vài tháng, nhóm phân tích dữ liệu, nhóm quản trị rủi ro, khối CNTT vận hành chatbot nội bộ, rồi các khoa và phòng thí nghiệm đều muốn dùng chung. Không có lớp quản trị, việc chia sẻ thường rơi vào ba tình huống quen thuộc:
Ai đến trước dùng trước
Một notebook giữ nguyên GPU 96 GB cả tuần dù chỉ chạy vài giờ; nhóm khác phải xếp hàng hoặc đề xuất mua thêm máy.
Cấp phát qua ticket
Đội hạ tầng tạo VM, cài driver, CUDA, framework cho từng yêu cầu. Mỗi lần mất nhiều ngày và cấu hình không đồng nhất.
Không biết ai dùng bao nhiêu
Không có số liệu theo phòng ban thì không phân bổ được chi phí, cũng không có căn cứ để quyết định mua thêm GPU.
Vấn đề không nằm ở phần cứng mà ở chỗ thiếu một GPU PaaS nội bộ: lớp nền tảng biến máy chủ GPU thành dịch vụ có danh mục, hạn mức, phân quyền và báo cáo sử dụng. Rafay mô tả đúng mô hình này trên trang GPU PaaS: cung cấp GPU bare metal, máy ảo và cụm Kubernetes dưới dạng dịch vụ, với multi-tenancy cho nhiều đơn vị kinh doanh trên cùng một nền tảng.
2. Kiến trúc GPU PaaS nội bộ với Rafay trên máy chủ GPU Supermicro
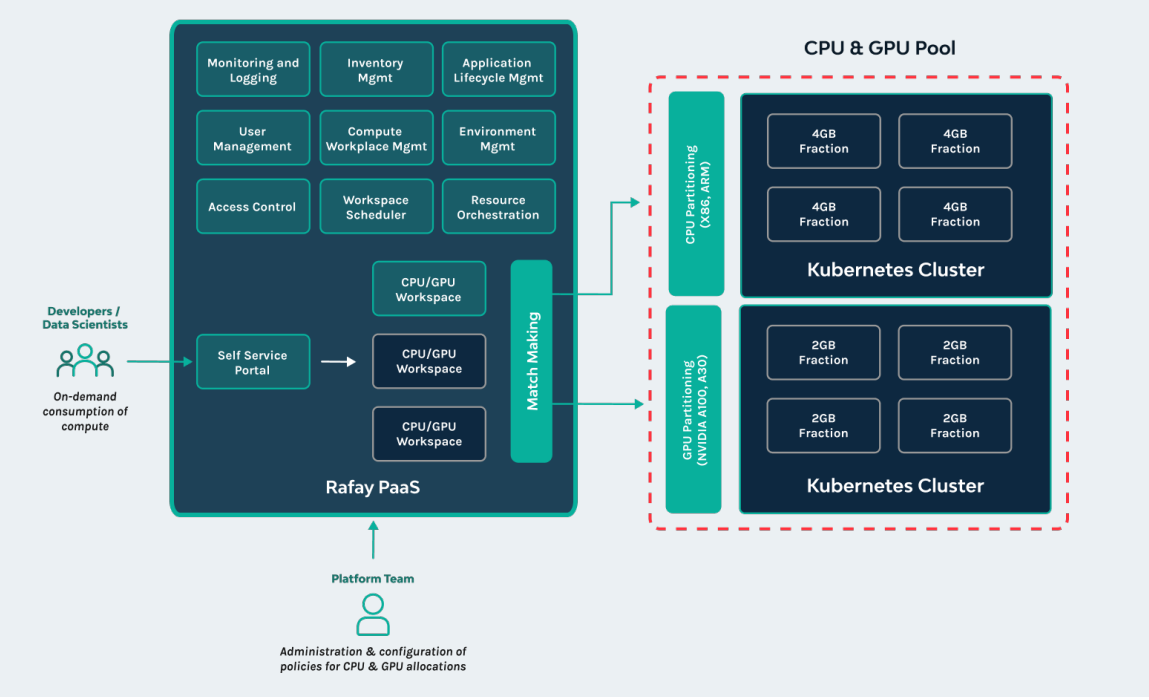
Một GPU PaaS nội bộ có bốn lớp (Hình 1). Người dùng chỉ thấy lớp trên cùng; đội nền tảng quản trị lớp giữa; lớp dưới cùng là pool máy chủ GPU Supermicro.
Hai điểm đáng chú ý khi đặt Rafay lên máy chủ GPU Supermicro:
- Không khóa vào một kiểu cấp phát. Rafay hỗ trợ bare metal GPU, máy ảo và cụm Kubernetes, nên cùng một pool máy chủ có thể vừa chạy notebook trên Kubernetes, vừa cấp VM GPU cho ứng dụng cần môi trường riêng. Tháng 8/2026, VMaaS của Rafay đạt chứng nhận NVIDIA-Certified Hypervisors (chương trình áp dụng cho hệ thống NVIDIA HGX và NVL72).
- Chuẩn hóa cụm bằng blueprint. Theo Rafay, một blueprint GPU điển hình gồm NVIDIA GPU Operator, KAI Scheduler, DCGM Exporter, OPA Gatekeeper và runtime Kata, chọn MIG hoặc time-slicing theo từng cụm. Khi thêm máy chủ mới, chỉ cần áp blueprint để có cấu hình giống hệt.
3. Tổ chức tenant và quota GPU theo phòng ban
Rafay đặt hạn mức (quota) ở ba cấp: Org, Project và từng người dùng; cấp dưới luôn là tập con của cấp trên, và quota tính theo SKU (ví dụ số instance Small, Medium, Large), theo hướng dẫn quota của Rafay. Đây là nền tảng để chia sẻ máy chủ GPU công bằng. Cách ánh xạ tự nhiên cho doanh nghiệp: Org là toàn tổ chức, Project là phòng ban hoặc dự án, User là từng cán bộ (Hình 2). Quota cấp người dùng ngăn một cá nhân dùng hết tài nguyên của cả phòng.
| SKU | Tài nguyên GPU | Cách chia | Dùng cho | Ai được dùng |
|---|---|---|---|---|
| Small | 1/4 GPU, khoảng 1/4 bộ nhớ 96 GB | MIG (cách ly phần cứng) | Notebook, thử prompt, mô hình 7–8B lượng tử hóa | Mọi phòng ban, quota theo người |
| Medium | 1 GPU nguyên (96 GB) | Nguyên GPU (K8s) / passthrough (VM) | Fine-tune LoRA, suy luận mô hình cỡ vừa | Dữ liệu & AI, nghiên cứu |
| Large | 4 GPU trên cùng một máy | Nguyên GPU (K8s) / passthrough (VM) | Fine-tune lớn hơn, endpoint mô hình 70B | Theo phê duyệt |
| Shared | Phần GPU theo thời gian | Time-slicing (không cách ly bộ nhớ) | Lớp học, workshop, tác vụ nhẹ ngắn | Khoa, đào tạo nội bộ |
Danh mục nên ngắn: 3–5 SKU là đủ cho đa số tổ chức. Rafay cho phép đặt giá theo SKU, theo từng thành phần tài nguyên hoặc kết hợp, kèm giá riêng cho từng tenant (Rafay usage), nên có thể bắt đầu bằng showback (chỉ báo cáo) rồi chuyển sang chargeback khi các phòng ban đã quen.
4. Chia một GPU cho nhiều người: MIG hay time-slicing
Muốn chia sẻ máy chủ GPU hiệu quả, cần chia nhỏ từng GPU, vì phần lớn tác vụ thử nghiệm không cần nguyên một GPU. Rafay hỗ trợ chia GPU bằng MIG hoặc time-slicing, bên cạnh cấp nguyên GPU; người dùng chỉ chọn “0,25 GPU” hay “0,5 GPU” từ danh sách, còn chi tiết profile do đội nền tảng định nghĩa (Rafay: fractional GPU tự phục vụ). Hai cơ chế chia khác nhau ở chỗ có cách ly bộ nhớ hay không (Hình 3).
| GPU | Bộ nhớ | MIG tối đa | Gợi ý chia trong GPU PaaS |
|---|---|---|---|
| RTX PRO 6000 Blackwell Server Edition | 96 GB | 4 phần | SKU Small qua MIG cho notebook và mô hình nhỏ; nguyên GPU cho fine-tune |
| H200 (SXM / NVL) | 141 GB | 7 phần | Nhiều phần nhỏ cách ly cho nhóm đông; nguyên GPU hoặc nhóm 8 GPU NVLink cho mô hình lớn |
| H100 (SXM / PCIe) | 80–94 GB | 7 phần | Tương tự H200, phù hợp hạ tầng HGX đã có |
| L40S | 48 GB | Không hỗ trợ | Cấp nguyên GPU, hoặc time-slicing cho tác vụ nhẹ |
Theo tài liệu NVIDIA GPU Operator, time-slicing không có cách ly bộ nhớ hay lỗi giữa các bản sao. Vì vậy, với ngân hàng, dữ liệu khách hàng hoặc mô hình chấm điểm rủi ro nên chạy trên phần MIG hoặc GPU nguyên; time-slicing để dành cho lớp học, workshop và thử nghiệm không nhạy cảm.
5. Luồng tự phục vụ, thu hồi GPU nhàn rỗi và chargeback
Với Rafay Developer Hub, cán bộ phòng ban tự tạo notebook Jupyter hoặc Developer Pod từ danh mục đã duyệt. Theo Rafay, một Developer Pod có SSH sẵn sàng trong khoảng 30 giây, với image Ubuntu và PyTorch/CUDA dựng sẵn; người dùng không phải thấy namespace hay quota. Mọi yêu cầu đều được kiểm tra với quota trước khi cấp phát (Hình 4).
Ba cơ chế giữ cho pool không bị “giữ chỗ”:
- Kiểm quota trước khi cấp phát: trang Rafay Self-Service nêu mọi triển khai được đối chiếu với quota, kèm cơ chế thu hồi tự động (automated reclamation) và quy tắc chargeback theo tổ chức. Ngưỡng nhàn rỗi và thời hạn cụ thể nên chốt cùng các phòng ban trong PoC.
- Lập lịch theo hàng đợi: KAI Scheduler hỗ trợ gang scheduling, hàng đợi phân cấp và cấp phát dưới một GPU, nên job huấn luyện của một phòng không chiếm chỗ vô thời hạn của phòng khác.
- Báo cáo sử dụng theo tenant: dữ liệu sử dụng xuất qua API hoặc CSV phục vụ showback, chargeback (Rafay reference architecture). Đây là căn cứ để CIO quyết định mua thêm GPU dựa trên mức dùng thật thay vì cảm tính.
Ngoài notebook và pod, Rafay còn cung cấp Token Factory (GA tháng 4/2026) để phục vụ mô hình qua API tính theo token, có phân quyền và quota (Rafay). Với doanh nghiệp, đây là cách để khối CNTT vận hành một mô hình dùng chung cho nhiều ứng dụng, thay vì mỗi phòng tự dựng endpoint riêng.
6. Chọn máy chủ GPU Supermicro cho pool dùng chung
Khi chia sẻ máy chủ GPU qua GPU PaaS nội bộ, tiêu chí chọn máy khác với máy cho một dự án: ưu tiên GPU hỗ trợ MIG để chia nhỏ có cách ly, đủ RAM và NVMe cục bộ cho nhiều người dùng đồng thời, và khả năng thêm máy giống hệt vào cụm. Ba dòng máy chủ GPU Supermicro dưới đây phù hợp các quy mô khác nhau (thông số từ trang sản phẩm Supermicro).
| Model | Kiểu máy, CPU | GPU | Bộ nhớ, lưu trữ | Vai trò trong pool |
|---|---|---|---|---|
| SYS-522GA-NRT | 5U, 2× Intel Xeon 6900 (tới 128 nhân/CPU) | Tới 8 GPU hai khe hoặc 10 GPU một khe; RTX PRO 6000 / 4500 Blackwell Server Edition | 24 DIMM, tới 6 TB DDR5; 24 khay NVMe 2,5″ | Máy chủ lực cho pool doanh nghiệp: 8 GPU × 4 phần MIG = tới 32 instance cách ly mỗi máy |
| AS-4125GS-TNRT | 4U, 2× AMD EPYC 9004/9005 | Tới 8 GPU hai khe: L40S, RTX PRO 4000/4500/5000 Blackwell và các GPU khác theo trang hãng | 24 DIMM, tới 6 TB DDR5 | Pool cho lớp học, notebook nhẹ (time-slicing hoặc nguyên GPU), suy luận mô hình nhỏ |
| SYS-821GE-TNHR | 8U, 2× Intel Xeon Scalable thế hệ 4/5 | HGX H100 hoặc H200 8 GPU, NVLink/NVSwitch | 32 DIMM, tới 8 TB DDR5 | Nhóm GPU cho fine-tune và mô hình lớn; có thể cấu hình MIG tới 7 phần mỗi GPU cho các nhóm nhỏ (đổi profile MIG cần lên kế hoạch, không đổi tức thời) |
Một cách bắt đầu hợp lý cho ngân hàng hoặc đại học: hai máy SYS-522GA-NRT tạo pool 16 GPU RTX PRO 6000, một máy chia MIG cho notebook và mô hình nhỏ, máy còn lại cấp nguyên GPU cho fine-tune và endpoint. Khi nhu cầu mô hình lớn tăng, bổ sung máy HGX vào cùng control plane Rafay. Phần sizing VRAM cho từng mô hình xem thêm bài chọn máy chủ GPU Supermicro cho suy luận GenAI; khi lên cụm nhiều máy, tham khảo bài mạng cho cụm máy chủ GPU.
Về hệ sinh thái: Supermicro có tên trong danh sách đối tác của Rafay; Rafay là nền tảng phần mềm chạy trên Kubernetes và VM, không gắn với một hãng phần cứng. Khi thiết kế, nên kiểm tra phiên bản driver, GPU Operator và profile MIG của đúng GPU trong PoC.
7. Lộ trình triển khai GPU PaaS nội bộ trong 5 bước
- Khảo sát nhu cầu theo phòng ban: loại tác vụ (notebook, fine-tune, suy luận), số người dùng, giờ cao điểm, yêu cầu cách ly dữ liệu.
- Thiết kế danh mục SKU và quota: 3–5 SKU, quota Org/Project/User, chính sách thu hồi GPU nhàn rỗi, quy trình xin vượt quota.
- Sizing và chuẩn bị hạ tầng: chọn máy chủ GPU Supermicro, chế độ chia GPU cho từng máy, mạng, điện và làm mát; cài control plane Rafay (SaaS hoặc tự vận hành, có tùy chọn air-gapped theo kiến trúc tham chiếu của Rafay).
- PoC với hai đến ba phòng ban: đo thời gian cấp phát, tỷ lệ dùng GPU, phản hồi người dùng; tinh chỉnh SKU và quota.
- Mở rộng và vận hành: tích hợp SSO, bật showback rồi chargeback, đưa thêm máy vào cụm bằng blueprint, theo dõi định kỳ để quyết định đầu tư tiếp.
8. Câu hỏi thường gặp
GPU PaaS nội bộ khác gì so với cấp VM GPU thủ công?
GPU PaaS biến máy chủ GPU thành dịch vụ có danh mục SKU, quota theo phòng ban, cổng tự phục vụ và báo cáo sử dụng. Người dùng tự tạo notebook hoặc môi trường trong vài phút thay vì chờ ticket, còn đội hạ tầng quản lý chính sách thay vì cấu hình từng máy.
Nên dùng MIG hay time-slicing để chia sẻ máy chủ GPU?
MIG chia GPU thành các phần có tài nguyên tính toán và bộ nhớ riêng, phù hợp khi cần cách ly giữa các phòng ban hoặc dữ liệu nhạy cảm. Time-slicing để nhiều tác vụ luân phiên dùng GPU, tận dụng tốt cho tác vụ nhẹ nhưng không cách ly bộ nhớ. Nhiều tổ chức kết hợp cả hai trên các máy khác nhau.
GPU nào hỗ trợ MIG cho mô hình chia sẻ nhiều phòng ban?
Theo NVIDIA, RTX PRO 6000 Blackwell Server Edition hỗ trợ tối đa 4 phần MIG, H100 và H200 tối đa 7 phần. L40S không hỗ trợ MIG, nên thường cấp nguyên GPU hoặc dùng time-slicing.
Rafay có triển khai được trong môi trường không kết nối Internet không?
Có. Rafay công bố tùy chọn triển khai air-gapped hoàn toàn, với control plane tự vận hành trong hạ tầng của doanh nghiệp, phù hợp yêu cầu của ngân hàng và cơ quan có quy định về dữ liệu.
Bắt đầu GPU PaaS nội bộ cần bao nhiêu máy chủ GPU Supermicro?
Có thể bắt đầu từ một máy 8 GPU, nhưng hai máy giúp tách vai trò: một máy chia MIG cho notebook và mô hình nhỏ, một máy cấp nguyên GPU cho fine-tune và suy luận. Quy mô thực tế nên chốt sau khảo sát nhu cầu và PoC.
Đọc thêm về hạ tầng AI