Object storage cho AI: bài học từ hạ tầng lưu trữ của Meta thời Muse
Data & AI Storage · Phân tích kiến trúc
Object storage cho AI đang trở thành nền móng dữ liệu của các cụm huấn luyện lớn. Theo Meta (công ty mẹ Facebook), siêu cụm Prometheus với hàng trăm nghìn GPU là nơi huấn luyện các mô hình Muse; theo Blocks & Files, lưu trữ của Prometheus là BLOB đa tầng trên Tectonic, cache từ RAM máy chủ GPU tới HDD. Bài viết tách bạch điều Meta công bố, điều Blocks & Files tổng hợp, bài học cho doanh nghiệp Việt Nam và cách dựng kiến trúc tương tự với Cloudian trên Supermicro.
1. Meta đã công bố gì về lưu trữ cho AI và Muse
Ba nguồn chính thức của Meta và một bài tổng hợp cần đọc cùng nhau:
- Muse Spark (08/04/2026, Meta AI blog). Mô hình đầu tiên trong họ Muse của Meta Superintelligence Labs. Bài không nói về lưu trữ.
- Meta’s AI Storage Blueprint at Scale (01/07/2026, Engineering at Meta). Mô tả cách Meta dựng lại lớp BLOB storage để GPU không phải chờ dữ liệu. Bài không nhắc tên Muse.
- Inside Prometheus (19/10/2026, Engineering at Meta). Giai đoạn một của cụm Prometheus tại Ohio “đã được dùng để huấn luyện các mô hình nền tảng Muse”. Về lưu trữ, bài chỉ nêu checkpoint được ghi bất đồng bộ xuống “lưu trữ đa tầng”.
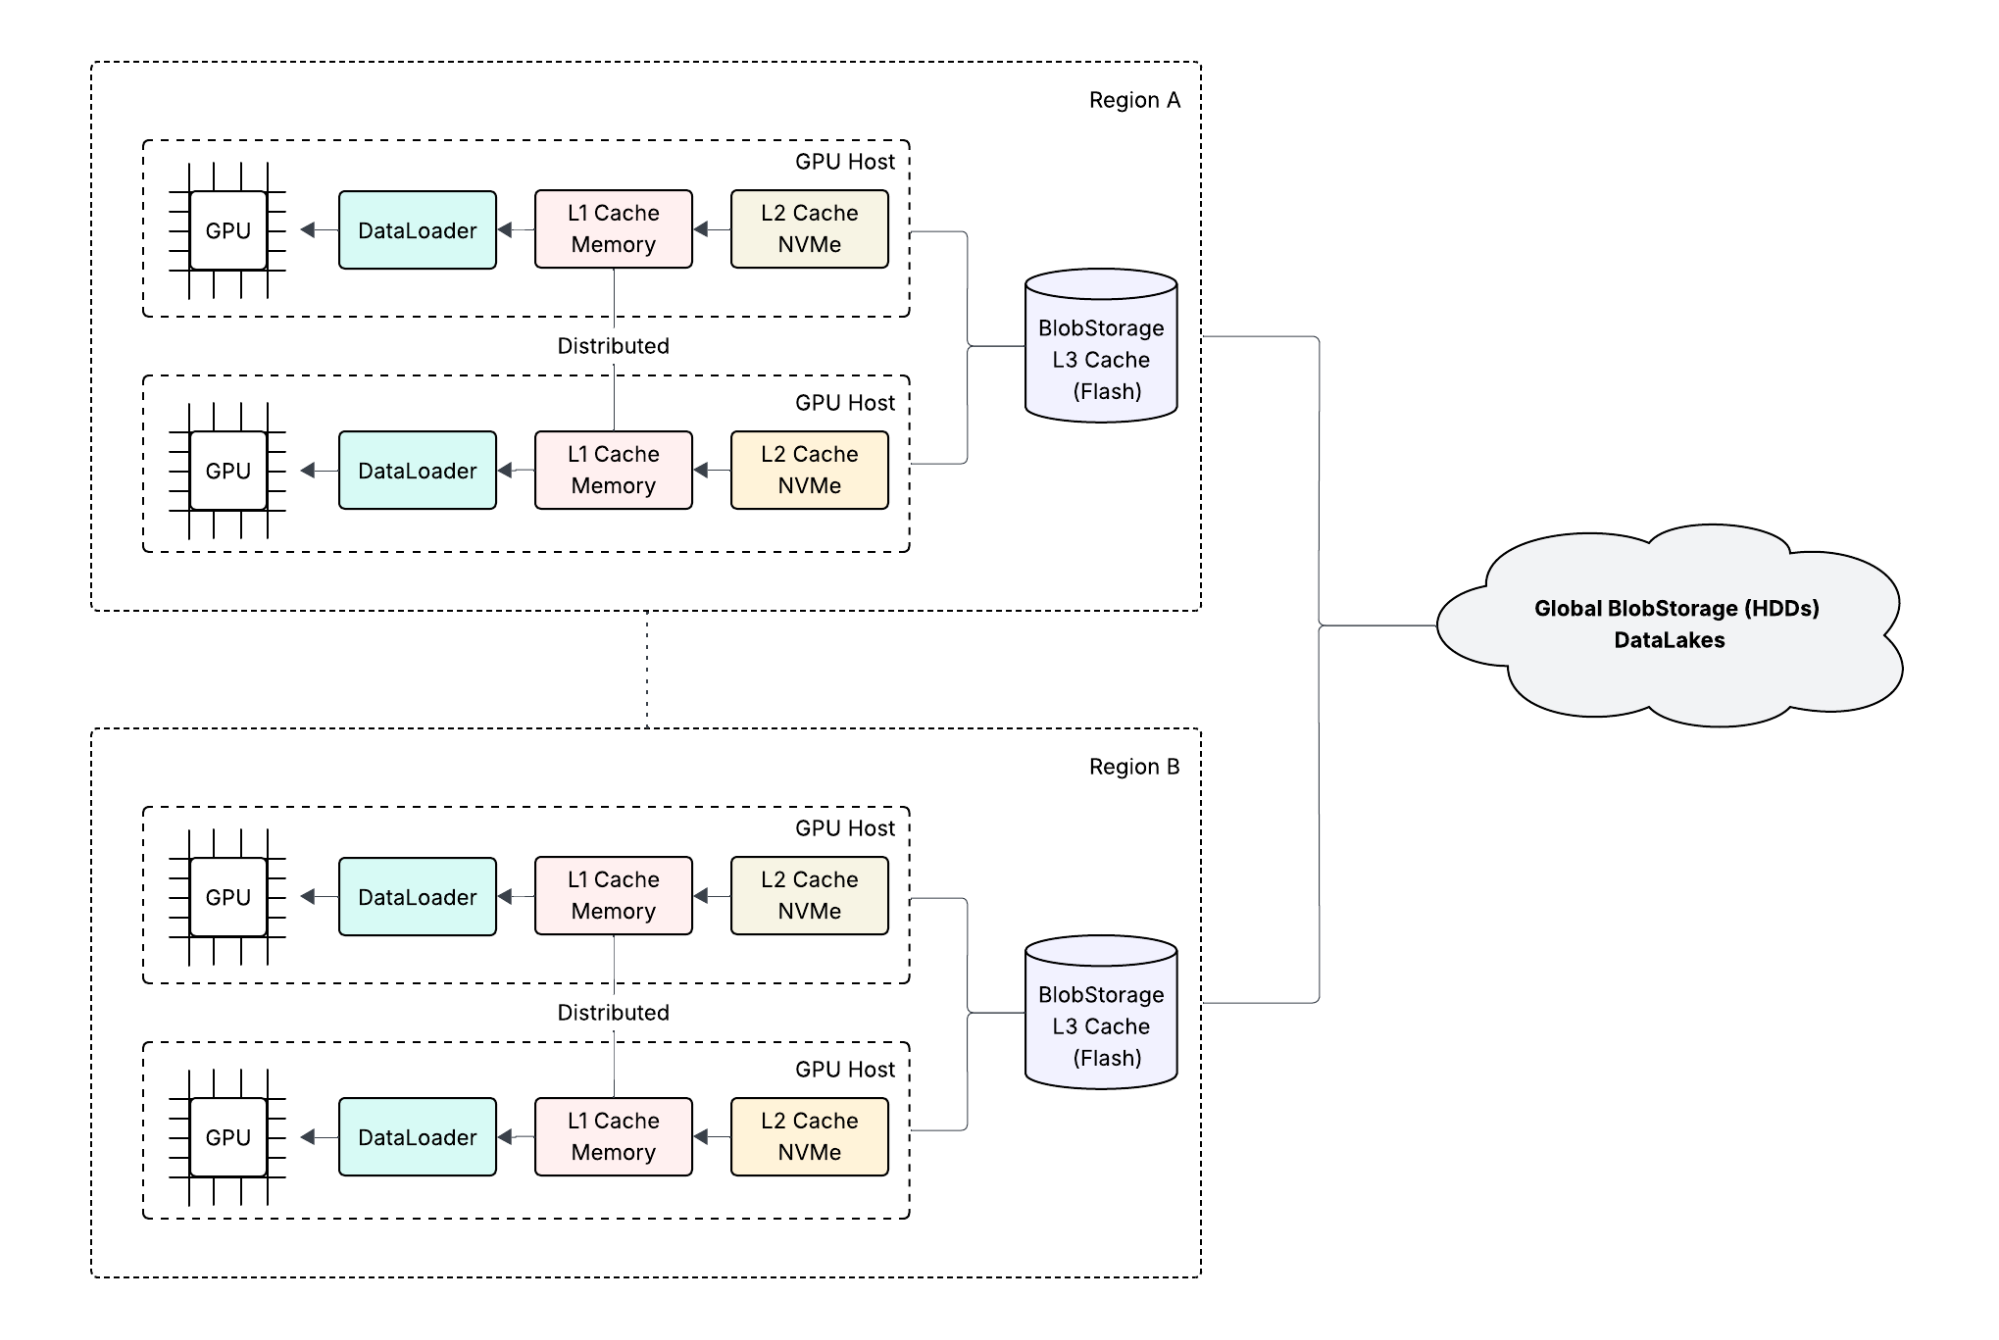
- Blocks & Files (20/10/2026). Tổng hợp hai bài trên: lưu trữ của Prometheus là stack đa tầng trên Tectonic với giao diện BLOB, gồm 4 lớp: RAM và flash trên máy chủ GPU (L1/L2), BLOB vùng trên flash (L3) và BLOB trên HDD làm nguồn gốc (L4).
Như vậy, liên hệ giữa Muse và object storage được Blocks & Files nối lại từ hai bài của Meta: Muse được huấn luyện trên Prometheus, và lưu trữ của Prometheus đang chuyển sang BLOB đa tầng. Meta chỉ viết rằng stack huấn luyện “đang chuyển dần” sang BLOB, sau khi Llama từng dùng giao diện file kiểu NFS trên Tectonic.
Prometheus theo số
Quy mô
Nhiều tòa nhà tại New Albany, Ohio; hướng tới khoảng 1 triệu GPU. Siêu cụm sắp tới là Hyperion ở Louisiana.
Nền tảng tính toán
Catalina và Clemente; HBM mỗi GPU tăng từ 192 GB lên 288 GB. Vera Rubin NVL72 (San Miguel) sắp có.
Lưu trữ
Theo Blocks & Files: RAM, flash trên máy chủ GPU, BLOB vùng trên flash, BLOB trên HDD. Inside Prometheus không mô tả lớp này.
Nguồn: thẻ 1–2 theo Inside Prometheus (Meta); thẻ 3 theo Blocks & Files.
2. Vì sao object storage cho AI trở thành lớp nền
Theo bài Blueprint, đường getObject cũ của Meta tra metadata qua nhiều lớp, mất tới hàng trăm mili giây, đủ làm cả nhóm GPU chờ trong huấn luyện đồng bộ. Meta chuyển sang metadata phẳng trên ZippyDB, client đọc thẳng từ storage server và BLOB theo vùng cạnh GPU. Meta dùng API BLOB nội bộ chứ không phải S3, nhưng doanh nghiệp áp dụng được cùng nguyên lý với object storage S3, vốn mở rộng ngang theo node.
3. Lưu trữ phân tầng như bộ nhớ của hệ điều hành
Theo cách làm truyền thống, nhà nghiên cứu của Meta sao chép dataset sang vùng có GPU trước khi chạy job, có khi mất hàng giờ. Mô hình mới coi lưu trữ như phân cấp bộ nhớ của hệ điều hành: L1 và L2 là RAM và flash trên chính máy chủ GPU, L3 là BLOB storage của vùng chạy trên flash, còn BLOB toàn cầu trên HDD là nguồn gốc, Meta gọi là “ultimate source of truth” (Blocks & Files đánh số L4). API prefetch() của SDK cho phép deep prefetch: nạp sẵn dữ liệu cần cho vài phút tới vào L3 và làm nóng cache metadata. L3 giữ dữ liệu trong khoảng thời gian cấu hình được để dùng lại qua các epoch, rồi loại bỏ theo TTL hoặc LRU. Cache metadata lưu read plan của các BLOB hay dùng, truy cập trong 1–2 ms. Meta cho biết cả hai cách, sao chép trước và nạp theo nhu cầu, vẫn cùng chạy trong production.
Kết quả Meta công bố: cache phân tán đạt tỷ lệ hit trung bình 80%, kèm biểu đồ thời gian ingest trước và sau khi triển khai, với mục tiêu để nhà nghiên cứu lặp thử “trong vài phút thay vì vài giờ”. SDxCentral và Blocks & Files cùng nêu thời gian ingest trung bình giảm từ 150 phút xuống 10 phút, trường hợp lớn nhất từ 89 giờ xuống 182 phút. Tinh thần này giống bài phân tầng lưu trữ KV cache cho suy luận AI.
Về phần cứng, Blocks & Files cho biết Meta tách hai nhóm nền tảng: flash (Yosemite V3.5, Crater Lake, ổ NVMe E1.S chuẩn OCP) cho truy cập độ trễ thấp, và Grand Canyon, khung 4OU chứa tới 72 ổ HDD 3,5 inch, cho dữ liệu dung lượng lớn. Cách chia hai tầng này giống cách mục 6 đề xuất cho doanh nghiệp (thiết bị khác nhau).
Lưu trữ AI của Meta qua ba giai đoạn
Phần bootnote của Blocks & Files điểm lại ba thế hệ lưu trữ AI của Meta; nhìn lại có thể thấy ngay hyperscaler cũng chuyển từ file sang object theo từng bước:
- AI Research SuperCluster: 16.000 GPU A100, lưu trữ all-flash Pure Storage FlashArray và FlashBlade.
- Llama 3 (2024): 49.152 GPU H100 chia hai cụm, Tectonic truy cập qua FUSE cùng Hammerspace điều phối dữ liệu.
- Prometheus: BLOB đa tầng trên Tectonic.
4. Checkpoint không làm GPU phải chờ
Bài Prometheus cho biết kiến trúc checkpoint phân tán của Meta lưu trạng thái mô hình, gồm gradient và dữ liệu optimizer, một cách bất đồng bộ xuống lưu trữ đa tầng. Delta checkpointing (chỉ ghi phần thay đổi) và in-memory staging giúp việc ghi ít ảnh hưởng tới throughput huấn luyện. Theo Blocks & Files, cách làm này giúp đạt goodput trên 85% ở các đợt pre-training; Meta cũng nêu con số này nhưng gắn với nỗ lực nâng độ tin cậy nói chung, không riêng checkpoint. Bài Blueprint bổ sung: đợt checkpoint tạo đỉnh lưu lượng gây nghẽn, timeout và retry, làm GPU phải chờ, nên Meta thêm cơ chế tự điều chỉnh concurrency vào client SDK; checkpoint không làm GPU dừng ở quy mô lớn hơn vẫn là hướng phát triển tiếp theo của Meta.
5. Bài học cho doanh nghiệp Việt Nam ở quy mô 100 TB đến vài PB
Doanh nghiệp không vận hành cụm exabyte, nhưng gặp cùng vấn đề ở quy mô nhỏ hơn: GPU chờ dữ liệu, sao chép dataset thủ công, checkpoint làm nghẽn NAS.
| Nguyên lý (theo Meta) | Áp dụng ở quy mô 100 TB – vài PB |
|---|---|
| Một nguồn dữ liệu gốc trên HDD | Một cụm object storage S3 làm data lake, erasure coding trên HDD, Object Lock cho dữ liệu cần bất biến. |
| Tầng flash gần GPU | Một tầng object all-flash NVMe cho dataset đang huấn luyện, checkpoint gần nhất, index vector. |
| Cache trên máy chủ GPU | NVMe cục bộ và RAM của máy chủ GPU làm cache cho dataloader; không cần tự viết hệ cache phân tán. |
| Prefetch trước job | Bước pipeline sao chép bucket từ tầng HDD sang tầng flash trước khi xếp lịch GPU. |
| Đọc thẳng, bỏ proxy | Ưu tiên S3 qua RDMA hoặc GPUDirect for Object Storage khi phần mềm hỗ trợ; tránh dồn mọi luồng qua một gateway. |
| Kiểm soát đỉnh ghi checkpoint | Ghi bất đồng bộ, giới hạn số luồng ghi đồng thời, QoS theo tenant. |
Khác biệt lớn nhất: ở quy mô này, hai nhóm node flash và HDD thường đủ, không cần tách vùng và toàn cầu như Meta. Chi phí tầng dung lượng được phân tích trong bài chi phí 1 PB object storage: Ceph RF3 hay Cloudian.
6. Triển khai object storage cho AI với Cloudian HyperStore trên Supermicro
Blocks & Files nhận định tổ chức không ở quy mô hyperscaler có thể dùng phần mềm object storage độc lập như Cloudian, MinIO hay Scality thay vì tự viết như Meta.
Cloudian HyperStore là object storage tương thích S3, hỗ trợ erasure coding và replication cấu hình theo bucket, Object Lock, multi-tenancy với IAM và QoS theo tenant, nhân bản nhiều site và lifecycle. Cho AI, Cloudian công bố hỗ trợ NVIDIA GPUDirect for Object Storage và RDMA cho S3, cho phép dữ liệu đi thẳng từ storage vào bộ nhớ GPU mà không đi qua CPU. HyperStore 8.2.6 đạt mức Foundation của NVIDIA-Certified Storage, cho cấu hình tới 128 GPU, theo trang của Cloudian.
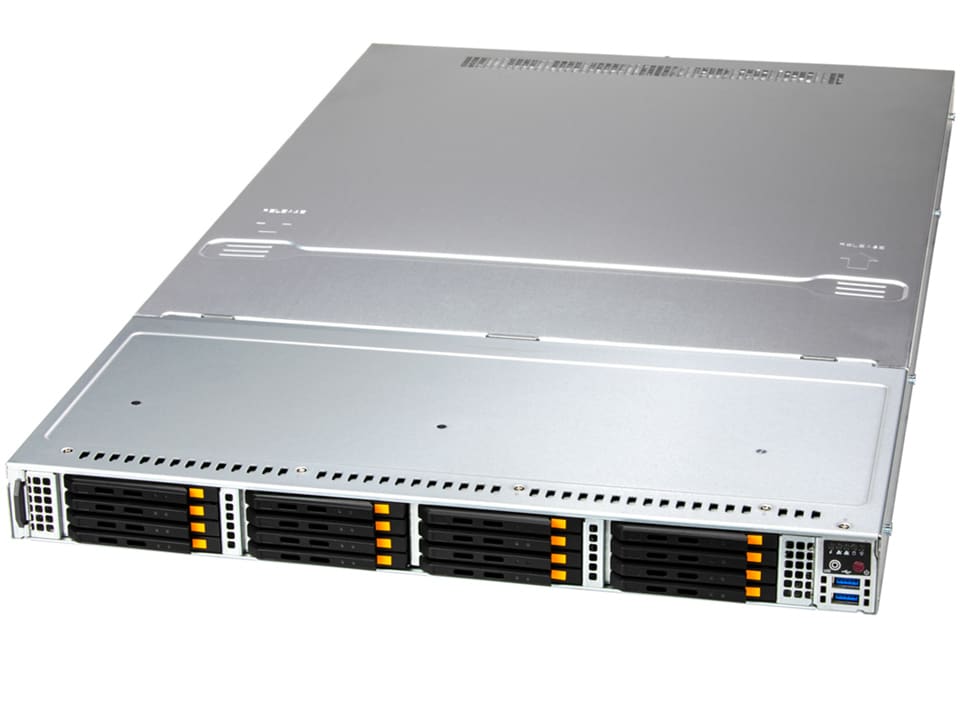
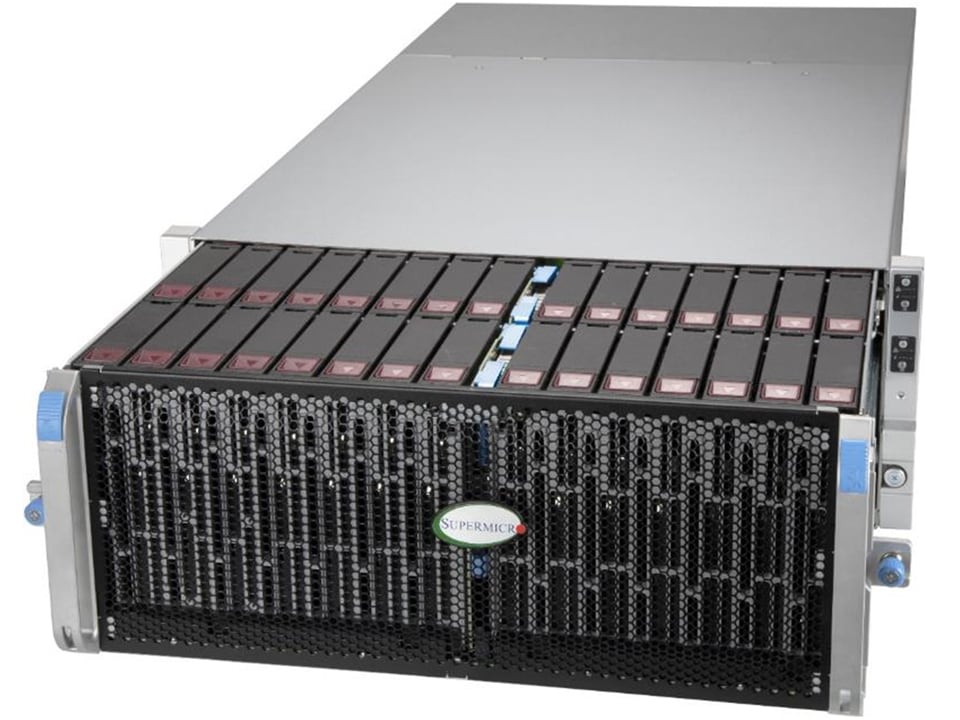
Về phần cứng, hai mẫu storage server Supermicro phù hợp cho hai tầng:
- Tầng hiệu năng: ASG-1115S-NE316R. 1U, một CPU AMD EPYC 9005/9004 (tới 96 nhân), 24 khe DDR5, 16 khay E3.S NVMe PCIe 5.0, 2 khe PCIe 5.0 x16 và 2 khe AIOM cho card mạng tốc độ cao.
- Tầng dung lượng: SSG-542B-DE1CR90. 4U top-loading, 2 node hot-plug, tổng 90 khay 3,5 inch SAS/SATA; mỗi node một CPU Intel Xeon 6700/6500, 16 khe DDR5 (tới 2 TB), 3 khe PCIe 5.0 x16.
Supermicro cung cấp phần cứng mật độ cao; CSC phụ trách sizing, ghép phần mềm, mạng RDMA, PoC và vận hành (xem giải pháp lưu trữ cho AI/HPC). Câu hỏi chi tiết về GPUDirect có trong FAQ Cloudian HyperStore và NVIDIA GPUDirect.
7. Lộ trình 5 bước
- Kiểm kê dữ liệu: dung lượng, tốc độ tăng, phần nóng, yêu cầu lưu giữ.
- Đo GPU chờ bao lâu: thời gian nạp dữ liệu, ghi checkpoint, mức sử dụng GPU.
- Dựng tầng dung lượng trước: cụm object HDD làm nguồn gốc, chuẩn hóa mọi pipeline về S3.
- Thêm tầng flash khi số đo cho thấy GPU chờ: bật RDMA cho S3 nếu framework hỗ trợ, thêm bước prefetch vào pipeline.
- Thiết lập chính sách: lifecycle, Object Lock, tenant theo phòng ban, giám sát.
8. Câu hỏi thường gặp về object storage cho AI
Meta có huấn luyện Muse hoàn toàn trên object storage không?
Meta chưa công bố điều này. Meta cho biết cụm Prometheus đã huấn luyện các mô hình Muse và checkpoint được ghi xuống lưu trữ đa tầng; bài Blueprint cho biết stack huấn luyện đang chuyển dần sang giao diện BLOB nhưng không nhắc tên Muse. Blocks & Files nối hai bài này và mô tả lưu trữ của Prometheus là BLOB 4 lớp trên Tectonic, trong đó dữ liệu vẫn đi qua RAM và flash trên máy chủ GPU.
BLOB storage của Meta có phải S3 không?
Không. Đây là dịch vụ nội bộ với API và SDK riêng trên Tectonic. Doanh nghiệp áp dụng nguyên lý qua object storage tương thích S3 như Cloudian HyperStore.
Doanh nghiệp vài trăm TB có cần tầng flash không?
Chưa chắc. Với ít GPU và job chủ yếu là fine-tune hoặc RAG, cụm object HDD cùng NVMe cục bộ thường đủ. Hãy đo thời gian GPU chờ dữ liệu trước khi đầu tư tầng flash.
Object storage có thay được file system song song cho huấn luyện?
Với nhiều pipeline đọc tuần tự các shard lớn, có. Với ứng dụng cũ cần POSIX hoặc nhiều file nhỏ, nên giữ file system hoặc đóng gói dữ liệu thành shard trước. Chính Meta cũng chuyển dần từ giao diện file kiểu NFS sang BLOB, không chuyển một lần.
Cloudian HyperStore có chạy trên phần cứng Supermicro?
HyperStore là object storage định nghĩa bằng phần mềm, chạy trên máy chủ tiêu chuẩn công nghiệp; Cloudian có liệt kê một kiến trúc tham chiếu Supermicro/Cloudian trên trang NVIDIA của hãng. CSC sizing và kiểm thử cấu hình cụ thể trước khi triển khai.
Prometheus của Meta lớn cỡ nào?
Theo Meta, Prometheus hiện có hàng trăm nghìn GPU và hướng tới khoảng 1 triệu, trên GB200, GB300 NVL72 và sắp tới là Vera Rubin NVL72. Doanh nghiệp không cần quy mô này để áp dụng nguyên lý phân tầng.